EU-dataresidentie verwijst naar de fysieke of geografische locatie waar de digitale gegevens van een organisatie worden opgeslagen en verwerkt, specifiek binnen de grenzen van de Europese Unie (EU) of de Europese Economische Ruimte (EER). EU-dataresidentie is voor bedrijven en organisaties belangrijk voor naleving van regelgeving, datasoevereiniteit en het vertrouwen van gebruikers. Vraag je je af wat EU-dataresidentie betekent voor de AI-stack van een onderneming en wil je weten welke punten je moet controleren voordat je een AI-platform kiest? Dan ben je hier aan het juiste adres!
In dit artikel leggen we uit wat EU-dataresidentie is en wat het in de praktijk betekent voor AI-stacks van ondernemingen.
TL;DR
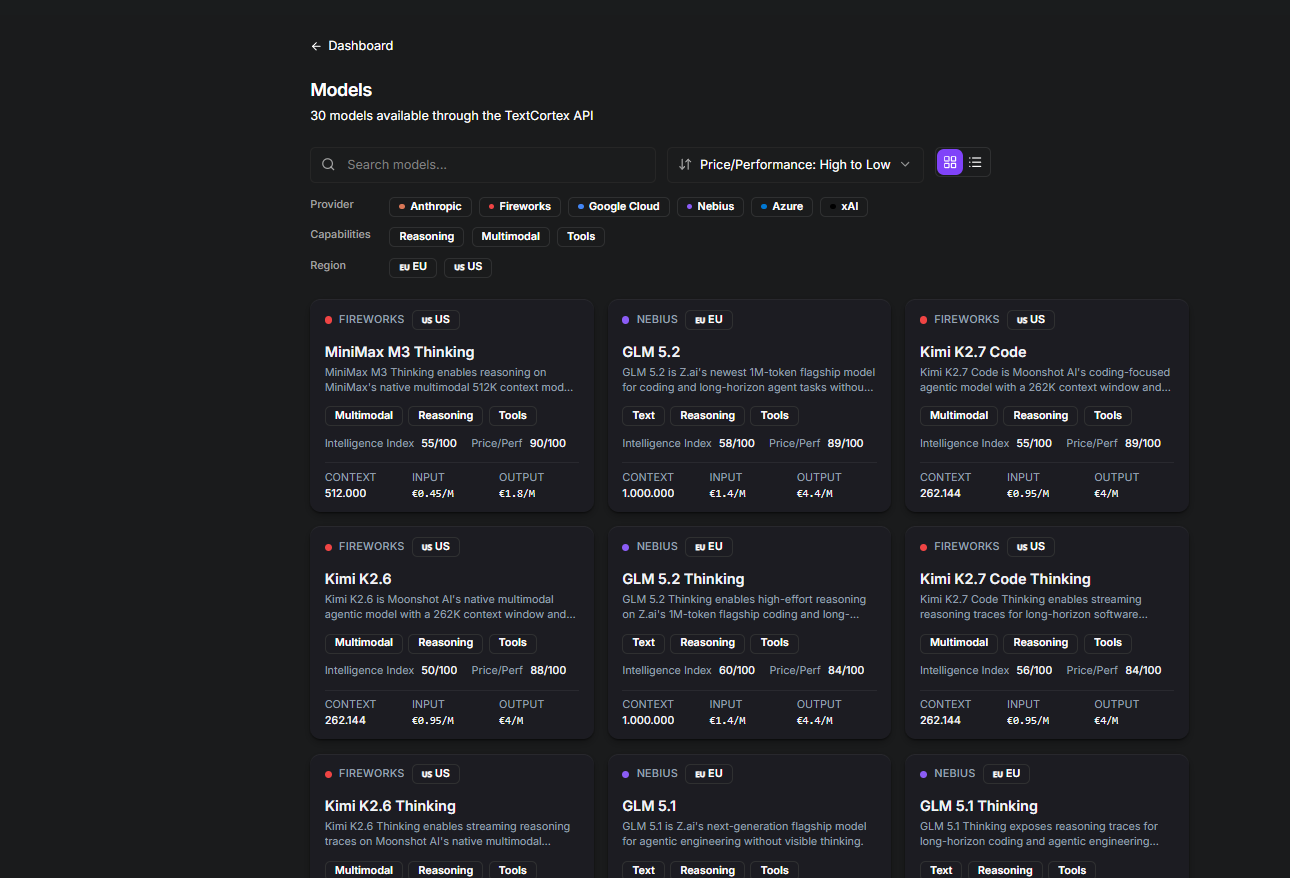
EU-dataresidentie betekent dat alle AI-gegevens van een onderneming binnen de grenzen van de EU of de EER worden opgeslagen en verwerkt. Het gaat daarbij niet alleen om waar het model draait, maar ook om waar prompts, opgehaalde content, context en logs zich bevinden. Het verschilt van verwante begrippen: residentie gaat over locatie, soevereiniteit over juridische jurisdictie en compliance over het voldoen aan governance-eisen. Om de residentieclaims van een AI-platform goed te beoordelen, controleer je vier lagen: inferentie (waar prompts worden verwerkt en output wordt gegenereerd), retrieval-indexen (waar bedrijfskennis wordt geïndexeerd en embeddings worden opgeslagen), contextvenster (hoe gespreksgeschiedenis, geheugen en bijgevoegde bestanden worden bewaard en beheerd) en reasoning-logs (operationele metadata, tool-traces en observability-gegevens). Een leverancier die zegt "gehost in Europa" zonder duidelijkheid te geven over alle vier de lagen, laat gaten in de compliance open. TextCortex dekt alle vier de lagen af en biedt via één API meer dan 24 in de EU gehoste, GDPR-conforme LLM's (waaronder GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro en voordelige alternatieven zoals Kimi K2.6, GLM 5.2 en DeepSeek V4 Pro), met ingebouwde monitoring, logging en auditing, AI-agents en kennisbanken voor ondernemingen.
Wat EU-dataresidentie betekent voor AI
AI-dataresidentie in de EU is voor organisaties en ondernemingen de snelste manier om generatieve AI, AI-agents en AI-modellen te gebruiken zonder concessies te doen aan gegevensbescherming. EU-dataresidentie voor AI beperkt zich niet tot het opslaan van AI-modeldata op in de EU gehoste servers; het vereist ook dat alle input- en outputdata van het model binnen de grenzen van de EU of de EER worden verwerkt.
Waarom is EU-dataresidentie belangrijk?
De kern van EU-dataresidentie is ervoor zorgen dat de datastroom van ondernemingen en organisaties bij elke stap van de workflow binnen de EU-grenzen blijft, zodat datalekken worden voorkomen. EU-dataresidentie beschermt gevoelige organisatie- en bedrijfsinformatie, waaronder prompts, opgehaalde content, logs, output en andere gegevens die door AI worden gebruikt of gegenereerd. Zo kun je als gebruiker duidelijk bijhouden en in kaart brengen waar de gegevens van je organisatie worden verwerkt, opgeslagen en gelogd.
Het verschil tussen dataresidentie, soevereiniteit en compliance
Op het eerste gezicht lijken dataresidentie, soevereiniteit en compliance hetzelfde te betekenen, maar het zijn verschillende aspecten van vergelijkbare vraagstukken. Het verschil tussen deze drie begrippen kunnen we kort als volgt samenvatten:
- Dataresidentie: waar gegevens worden opgeslagen of verwerkt.
- Datasoevereiniteit: welke jurisdictie invloed kan hebben op die gegevens.
- Compliance: of de totale opzet voldoet aan de wettelijke en governance-eisen.
Hosting in de EU is belangrijk voor AI-platforms, maar het is slechts één onderdeel van het grotere geheel.
De 4 lagen van EU-dataresidentie voor AI
Bij AI-dataresidentie gaat het niet alleen om waar de app wordt gehost. Het gaat ook om waar prompts worden verwerkt, waar bedrijfsgegevens worden geïndexeerd, hoeveel context wordt bewaard en wat er in logs wordt vastgelegd. Daarom kun je AI-residentie het best beoordelen aan de hand van 4 lagen: inferentie, retrieval, context en logs.
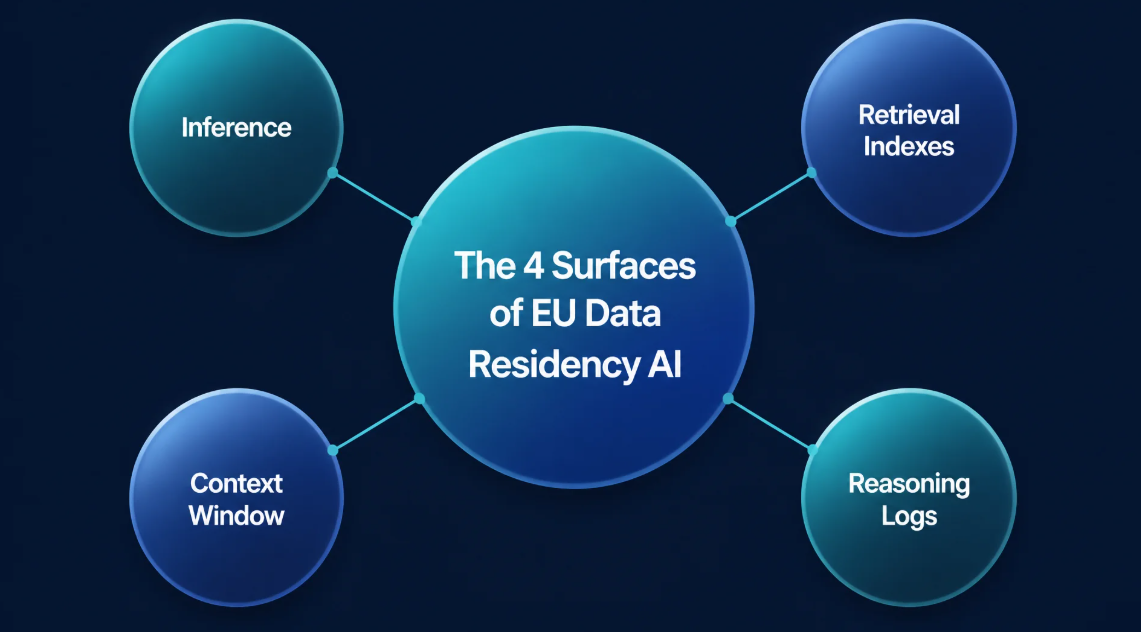
Laag 1: Inferentie
Dit is het moment waarop een gebruiker een prompt invoert, het model die verwerkt en de output wordt gegenereerd. Met andere woorden: bij inferentie wordt je verzoek daadwerkelijk een antwoord. Als je een AI-platform voor zakelijk gebruik beoordeelt, is dit een van de eerste dingen die je moet controleren. Inferentie kan betrekking hebben op interne documenten, klantgegevens, juridische vragen, strategische notities of operationele details. Als de inferentielaag onduidelijk is, wordt je hele AI-implementatie moeilijker te beheersen. Daarom mag inferentie nooit worden teruggebracht tot een marketingkreet als "gehost in Europa". Je hebt een duidelijk antwoord nodig op de vraag waar verzoeken worden verwerkt, hoe gegevens tijdens het genereren stromen en of promptgegevens worden bewaard nadat het antwoord is gegenereerd.
Laag 2: Retrieval-indexen
De tweede laag zijn de retrieval-indexen. Als de AI toegang heeft tot je kennis, moet je weten waar die kennis wordt geïndexeerd. Veel zakelijke AI-tools doen meer dan antwoorden genereren op basis van een prompt. Ze maken ook verbinding met bedrijfsgegevens, zoals interne documenten, wiki's, supportartikelen, pdf's, vergadernotities of clouddrives. Om die informatie doorzoekbaar te maken, maakt het platform vaak indexen aan. Juist hier verliezen veel kopers het grotere geheel uit het oog. Een leverancier kan zeggen dat zijn chatomgeving in de EU wordt gehost, maar als de retrieval-laag geïndexeerde bedrijfsgegevens ergens anders opslaat, is de residentievraag niet volledig beantwoord. Je moet weten waar die indexen staan, waar embeddings worden opgeslagen, waar gesynchroniseerde content wordt verwerkt en of gekoppelde bronnen binnen de beoogde regio blijven.
Waarom is dit belangrijk?
Omdat retrieval-indexen vaak de structuur van je bedrijfskennis bevatten. Ze lijken misschien niet op het oorspronkelijke document, maar vertegenwoordigen nog steeds bedrijfsgegevens. Als je AI-assistent kan zoeken in hr-beleid, klantenservicecontent, juridische sjablonen of productdocumentatie, wordt de retrieval-laag een belangrijk onderdeel van je compliance- en governance-review.
Laag 3: Contextvenster
De derde laag is het contextvenster. Dit is de laag die AI-systemen continuïteit geeft. Het omvat de informatie die in een sessie wordt meegenomen, zodat het model een relevanter antwoord kan genereren. Afhankelijk van het platform kan dat recente gespreksgeschiedenis, workspace-instructies, geheugen, agentinstellingen, bijgevoegde bestanden en gebruikersspecifieke context omvatten.
Waarom is dit belangrijk?
Omdat context zakelijke AI echt nuttig maakt. Het helpt het systeem te begrijpen wat je team vraagt, op welke gegevens het moet vertrouwen en hoe het moet antwoorden. Tegelijkertijd kan context ook gevoelig materiaal bevatten dat zorgvuldig moet worden beheerd. Je moet dus weten hoe lang gespreksgeschiedenissen worden bewaard, of beheerders de bewaartermijn kunnen regelen en of het geheugen beperkt is per workspace, gebruiker of project.
Laag 4: Reasoning-logs
De laatste, maar zeker niet de minste laag zijn de reasoning-logs. Reasoning-logs zijn de registraties die worden aangemaakt over hoe een AI-verzoek is afgehandeld. Afhankelijk van het platform kan dit gebruiksmetadata, tool-traces, debuggegevens, workflowstappen, tijdstempels, foutlogs, monitoringevents en andere observability-gegevens omvatten. Deze laag wordt gemakkelijk over het hoofd gezien, maar is een van de belangrijkste.
Waarom is dit belangrijk?
Omdat operationele logs, zelfs als een leverancier de bewaring van prompts beperkt, nog steeds betekenisvolle informatie kunnen vastleggen over hoe het systeem is gebruikt. Voor zakelijke kopers heeft dit gevolgen voor auditeerbaarheid, incidentrespons, beveiligingsreviews en interne governance. Een platform kan er aan de interfacekant sterk uitzien, maar als de reasoning-logs vaag, onbeperkt of slecht gedocumenteerd zijn, zullen securityteams dat merken. Daarom moeten volwassen leveranciers van zakelijke AI niet alleen duidelijk zijn over waar antwoorden worden gegenereerd, maar ook over hoe de volledige levenscyclus van een verzoek wordt gemonitord en vastgelegd.
TextCortex AI: Europese aanbieder van frontiermodellen en AI-oplossing voor ondernemingen
Ben je op zoek naar een Europese AI-aanbieder en een zakelijk AI-platform dat alle niveaus van EU-dataresidentie biedt? Dan is TextCortex de oplossing voor jou. TextCortex is een platform dat wil voldoen aan de AI-behoeften van ondernemingen door gebruikers frontier-AI-modellen aan te bieden die in de EU worden gehost en GDPR-conform zijn. Met TextCortex kun je via één API meer dan 24 grote taalmodellen gebruiken, in lijn met EU-dataresidentie. Daarnaast biedt TextCortex gebruikers monitoring, logging en auditing, zodat je je AI-modellen altijd in de gaten kunt houden. Laten we de functies van TextCortex eens nader bekijken.
Toegang tot in de EU gehoste LLM's
Met TextCortex kunnen gebruikers via één API 30 verschillende modellen gebruiken, allemaal gehost in de EU en GDPR-conform. Daaronder vallen frontier-AI-modellen zoals GPT-5.5, Claude Opus 4.7 en Gemini 3.1 Pro, maar ook alternatieve en voordelige opties zoals KimiK2.6, GLM 5.2 en DeepSeek V4 Pro.
In de EU gehoste zakelijke AI-ervaring
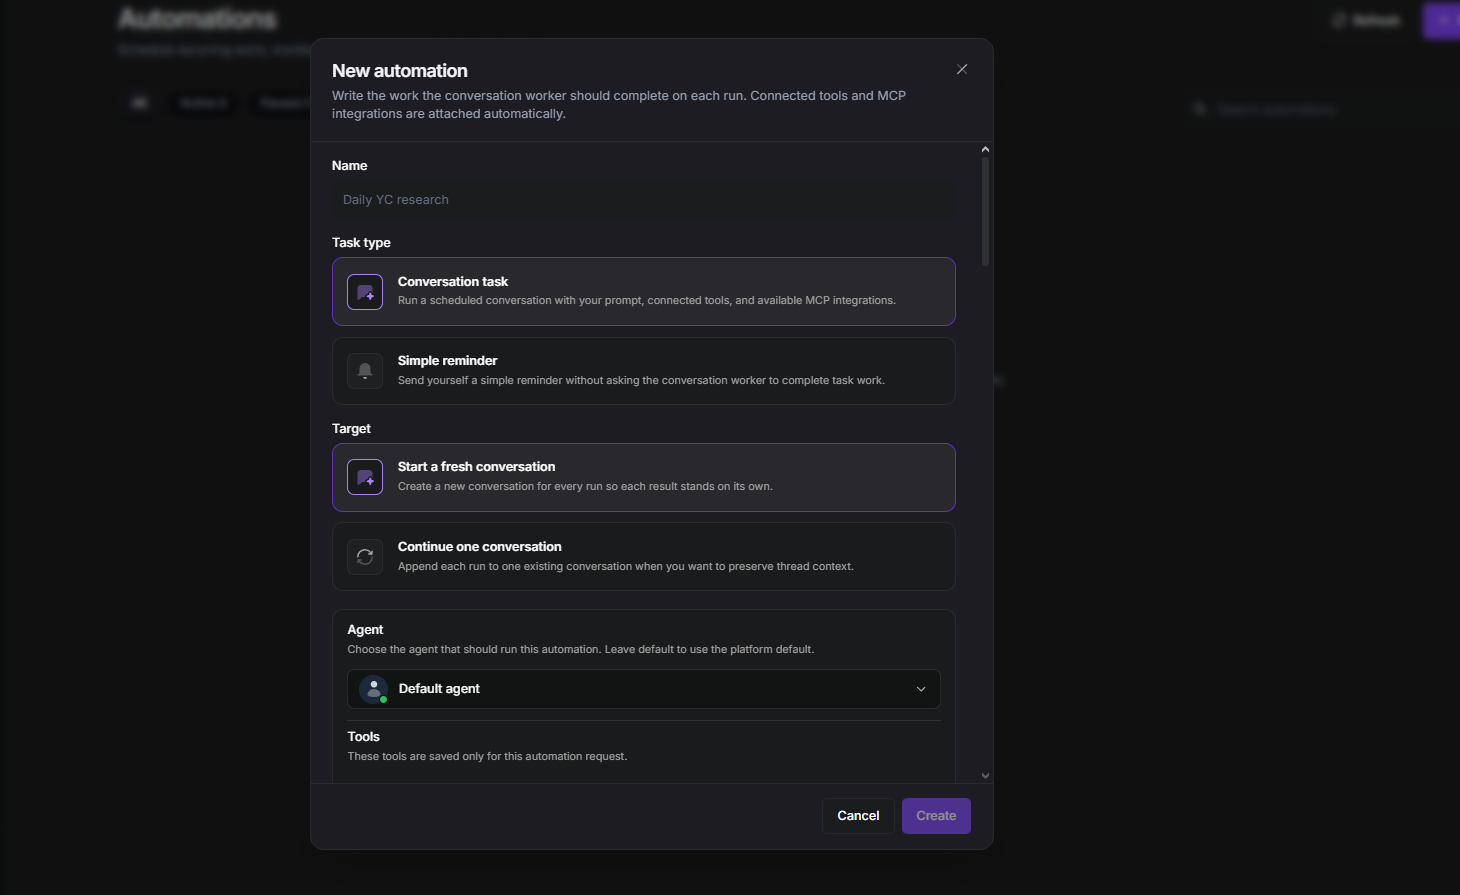
Naast LLM-aanbieder biedt TextCortex gebruikers ook een in de EU gehost, GDPR-conform AI-platform voor ondernemingen. Met TextCortex kun je complexe en repetitieve workflows automatiseren of je kennisbeheer verbeteren met een breed scala aan LLM's. Met het AI-agentframework van TextCortex bouw je automatiseringsagents voor specifieke taken. Bovendien kun je met onze kennisbanken je interne databases koppelen aan TextCortex om de informatie die je nodig hebt in gespreksvorm op te vragen of je ruwe data om te zetten in bruikbare resultaten.
Veelgestelde vragen
Wat is EU-dataresidentie voor AI?
Het verwijst naar waar AI-gerelateerde gegevens in de hele AI-stack worden verwerkt, opgeslagen, geïndexeerd of gelogd.
Is hosting in de EU hetzelfde als AI-soevereiniteit?
Nee. Bij hosting in de EU gaat het om locatie. Soevereiniteit omvat daarnaast jurisdictie, governance, zeggenschap en operationele onafhankelijkheid.
Wat moeten ondernemingen naast de locatie van inferentie controleren?
Ze moeten ook retrieval, context en logs controleren.
Kan een AI-tool GDPR-conform zijn als het Amerikaanse modelaanbieders gebruikt?
Dat hangt af van de architectuur, contracten, waarborgen, datastromen en governancemaatregelen. Kopers moeten de volledige verwerkingsketen controleren.