Na Anthropic en OpenAI heeft nu ook Google een model aangekondigd dat hoge prestaties levert met een lager tokenverbruik bij programmeren, kenniswerk en agentische redeneertaken: Gemini 3.6 Flash. Gemini 3.6 Flash is beschikbaar via de API en via Gemini AI, en verschijnt samen met de modellen 3.5 Flash Lite en 3.5 Flash Cyber. Ben je benieuwd wat Gemini 3.6 Flash is en wat het kan? Wij vertellen je er alles over!
In dit artikel bekijken we de functies en prestaties van Gemini 3.6 Flash.
TL;DR
Google bracht Gemini 3.6 Flash uit op 21 juli 2026: een lichtgewicht model met lage latentie, geoptimaliseerd voor programmeren, agentisch redeneren, multimodale taken en kenniswerk, met een sterke prijs-prestatieverhouding. Het is beschikbaar naast Gemini 3.5 Flash Lite en Gemini 3.5 Flash Cyber. Je kunt het gratis uitproberen via Gemini AI, en API-toegang kost $1.5 per miljoen input-tokens en $7.5 per miljoen output-tokens. Gemini 3.6 Flash gebruikt 17% minder tokens dan Gemini 3.5 Flash, waardoor de totale kosten dalen terwijl de prestaties verbeteren. Het beschikt ook over ingebouwd computergebruik voor betrouwbare agentische workflows en presteert beter dan frontiermodellen bij toolgebruik en kenniswerk, al blijft het op DeepSWE v1.1 nog 18% achter bij GPT-5.6 Luna. Standaard voldoet het model niet aan de EU AI Act of de GDPR, maar TextCortex biedt het aan als in de EU gehoste, compliant API en als motor voor aangepaste AI-agents, kennisbanken en workflowautomatisering.
Wat is Gemini 3.6 Flash?
Gemini 3.6 Flash is een groot taalmodel dat door Google is ontwikkeld en op 21 juli 2026 is uitgebracht. Vergeleken met zijn voorgangers biedt het geavanceerd programmeren, agentisch redeneren, hoge prestaties bij multimodale taken, lage latentie en betrouwbare prestaties. Gemini 3.6 Flash wil de optimale prijs-prestatieverhouding bieden voor agentische workflows. Het is ontwikkeld op basis van feedback van klanten en opmerkingen van ontwikkelaars over eerdere Gemini-modellen.
Is Gemini 3.6 Flash gratis te gebruiken?
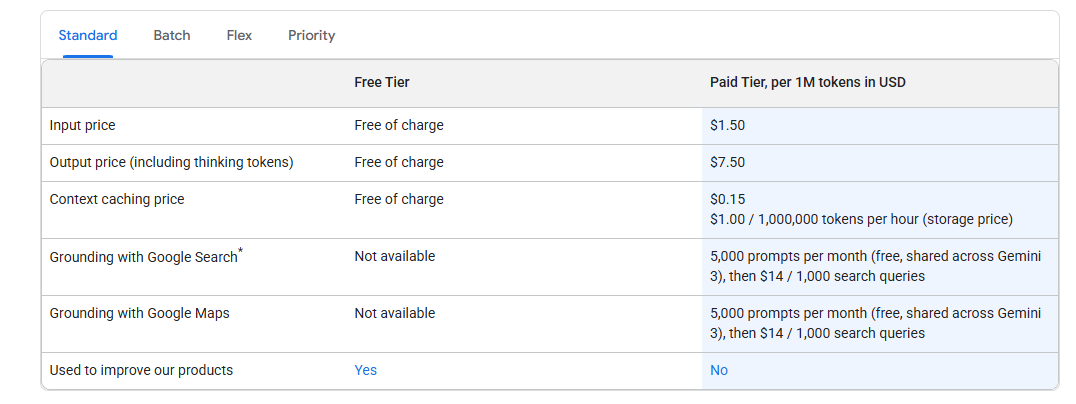
Je kunt het model Gemini 3.6 Flash gratis gebruiken en uitproberen via Gemini AI. Wil je Gemini 3.6 Flash echter als API gebruiken in de workflow van je bedrijf, dan betaal je volgens de API-prijzen. De API-prijzen voor het model Gemini 3.6 Flash zijn als volgt:
- $1.5 per miljoen input-tokens
- $7.5 per miljoen output-tokens
Hoe krijg je toegang tot Gemini 3.6 Flash?
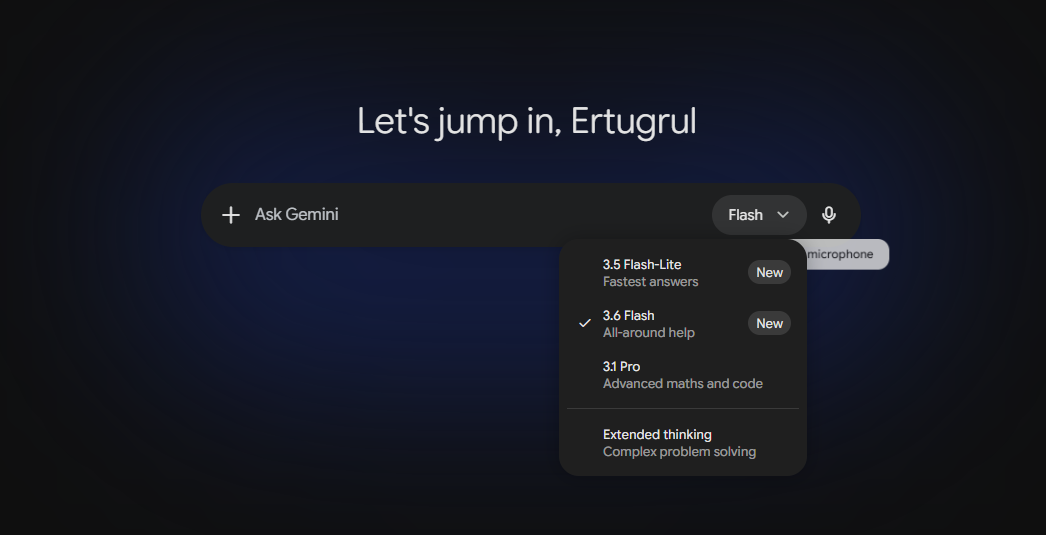
De eenvoudigste en meest directe manier om het model Gemini 3.6 Flash te gebruiken, is via de chatbot Gemini AI. Daar kun je het model Gemini 3.6 Flash gratis gebruiken.
Je kunt het model Gemini Flash 3.6 ook als API gebruiken. Zoek je echter een innovatieve en zakelijke manier om Gemini Flash 3.6 te gebruiken, dan kun je TextCortex inzetten. Met TextCortex integreer je een breed scala aan grote taalmodellen, waaronder Gemini Flash 3.6, in de workflow van je bedrijf.
Gemini 3.6 Flash: functies & prestaties
Het model Gemini 3.6 Flash brengt nieuwe functies, mogelijkheden en prestatiegrenzen met zich mee, waarvan een lager tokenverbruik het meest opvalt. Ben je benieuwd naar de functies van Gemini 3.6 Flash? We hebben ze voor je op een rij gezet!
Benchmarkprestaties
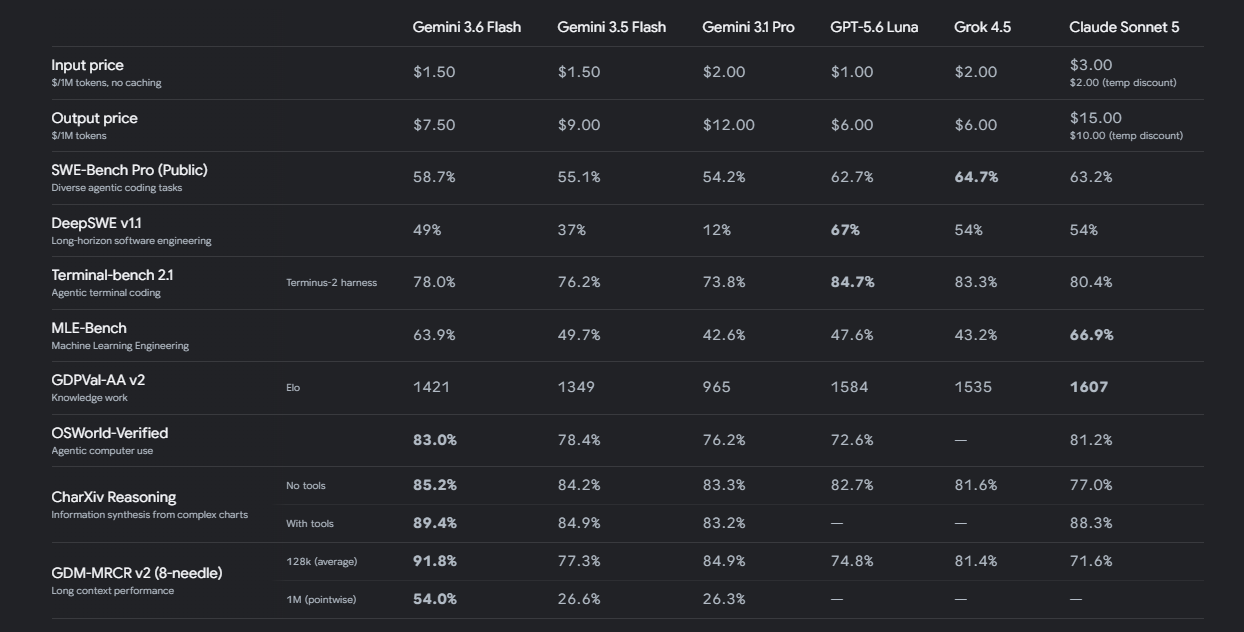
Hoewel het model Gemini 3.6 Flash aanzienlijk betere benchmarkprestaties levert dan zijn voorgangers, verslaat het de concurrentie niet in elke benchmark. Zo scoort Gemini 3.6 Flash in de benchmark OSWorld-Verified hoger dan zowel zijn voorgangers als de concurrenten, maar blijft het in de benchmark DeepSWE v1.1 18% achter bij het model GPT-5.6 Luna.
Lager tokenverbruik
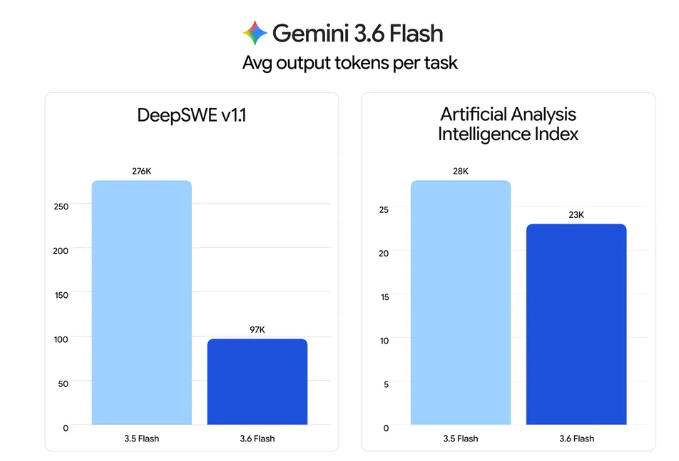
Het model Gemini 3.6 Flash gebruikt 17% minder tokens om dezelfde taken uit te voeren dan zijn voorganger, het model Gemini Flash 3.5. Volgens het artikel van Google verbruikte Gemini 3.6 Flash in de Artificial Analysis Index 17% minder tokens dan Gemini 3.5 Flash. Zo bespaar je met Gemini 3.6 Flash kosten doordat je minder tokens verbruikt in je geautomatiseerde workflows. Bovendien vergroten de lagere input- en outputprijzen ten opzichte van de voorganger je besparing aanzienlijk. En dankzij de hogere prestaties kan het model complexere taken eenvoudiger aan.
Betere agentische prestaties
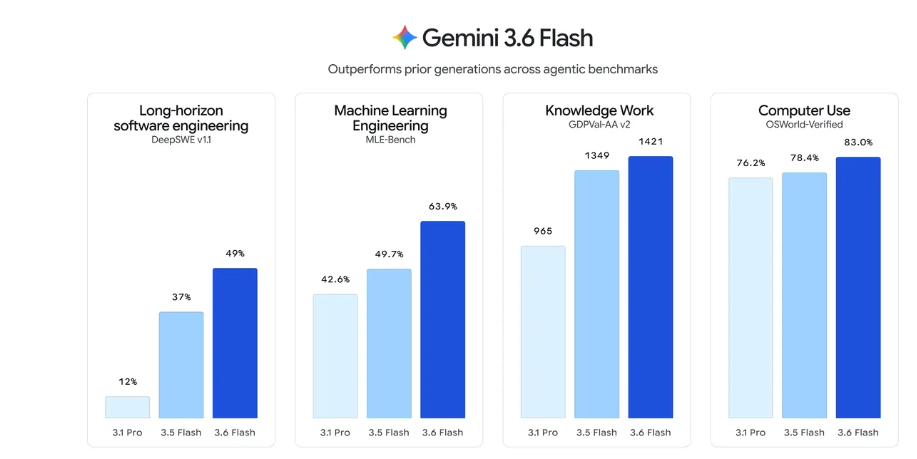
Het model Gemini 3.6 Flash presteert aanzienlijk beter op het gebied van agentisch redeneren, kenniswerk, toolgebruik en machine learning engineering dan zijn voorgangers, de modellen Gemini 3.5 Flash en Gemini Pro 3.1. Dankzij deze agentische prestaties is Gemini 3.6 Flash ideaal voor het automatiseren van repetitieve, complexe workflows met meerdere stappen. Daarnaast presteert Gemini 3.6 Flash beter dan frontiermodellen bij agentische taken met toolgebruik en kenniswerk. Het model heeft ook computergebruik als ingebouwde tool, zodat het agentische taken op verschillende oppervlakken betrouwbaar ondersteunt.
TextCortex AI: zet Gemini 3.6 Flash in voor je bedrijf
Wil je het model Gemini 3.6 Flash gebruiken om de workflow van je bedrijf te automatiseren en je kenniswerk te verbeteren? Dan is TextCortex AI de oplossing die je zoekt. TextCortex is een toonaangevend platform voor kennisbeheer en workflowautomatisering dat de werkdruk van bedrijven wil verlagen en hun tijd en kosten wil besparen. Met TextCortex kun je een breed scala aan krachtige frontier-taalmodellen gebruiken, waaronder Gemini 3.6 Flash, om de taken van je bedrijf te automatiseren of te versnellen.
Gebruik Gemini 3.6 Flash gehost in de EU
Standaard voldoet het model Gemini 3.6 Flash niet aan de EU AI Act en de GDPR. Wil je Gemini 3.6 Flash GDPR-conform gebruiken, dan is TextCortex de oplossing voor jou. Met de TextCortex API kun je Gemini 3.6 Flash gebruiken, gehost in de EU en GDPR-conform. TextCortex biedt frontier-LLM's, waaronder Gemini 3.6 Flash, en andere kostenefficiënte LLM's aan, gehost in de EU en GDPR-conform. Zo kun je Gemini 3.6 Flash zonder juridische problemen gebruiken in je bedrijven die in Europa actief zijn.
AI-agents aangedreven door Gemini 3.6 Flash
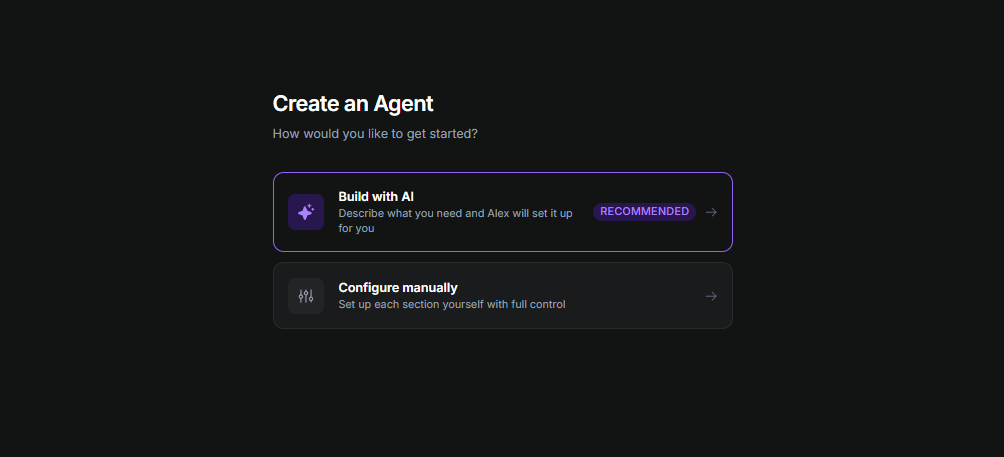
Een effectieve manier om het model Gemini 3.6 Flash te gebruiken, is door het als AI-agent in te zetten om je workflows te automatiseren of je taken te stroomlijnen. Met TextCortex kun je aangepaste AI-agents bouwen voor elke taak of workflow, en ze zelfs verfijnen met modulaire gedragsregels die "skills" heten. Er zijn twee manieren om met TextCortex een AI-agent te bouwen. De eerste is de AI-agent die je nodig hebt in een gespreksvorm te bouwen met ondersteuning van AI. De tweede is een handmatig bouwframework waarmee je alles kunt aanpassen, van het standaardmodel tot het gedrag dat de agent altijd of juist nooit moet vertonen.
Versterk je AI-agents met kennisbanken
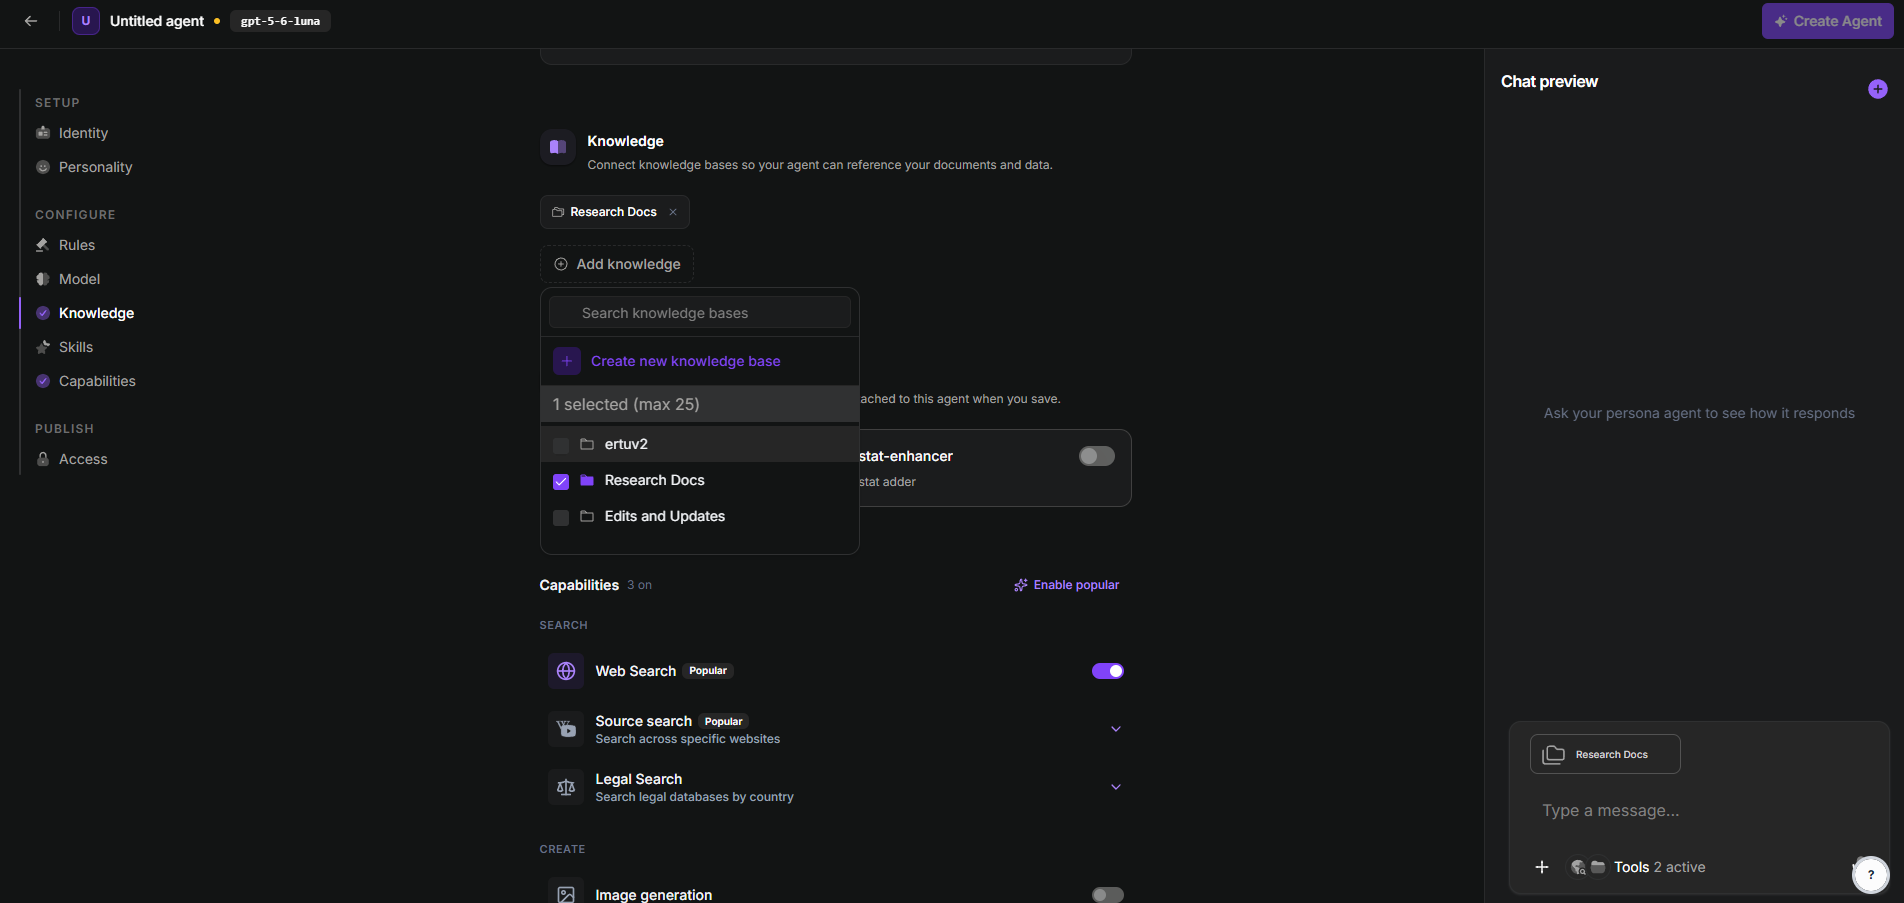
TextCortex biedt gebruikers kennisbanken waarin ze hun interne databases kunnen koppelen of documenten handmatig kunnen uploaden. Met onze kennisbanken integreer je de databases die je voor de taken van je bedrijf gebruikt in TextCortex. Vervolgens kun je deze databases via AI-chatbots gebruiken voor kenniswerk of AI-zoekopdrachten. Wil je dat je TextCortex AI-agents met specifieke databases werken, dan kun je je kennisbanken tijdens het bouwen aan de agents toewijzen. Een andere manier om AI-agents en databases samen te gebruiken, is door tijdens het gebruik de naam van de kennisbank met het symbool "@" in het chatvenster te typen, bijvoorbeeld "@Research Docs". Daarna kun je je gebouwde AI-agents gebruiken om met de gewenste kennisbank taken uit te voeren zoals data-analyse, AI-zoekopdrachten en het omzetten van ruwe data in inzichten.