Après Anthropic et OpenAI, Google a lui aussi annoncé son modèle offrant de hautes performances avec une consommation de tokens réduite pour le code, le travail intellectuel et les tâches de raisonnement agentique : Gemini 3.6 Flash. Gemini 3.6 Flash est accessible à la fois via l'API et via Gemini AI, et il est lancé en même temps que les modèles 3.5 Flash Lite et 3.5 Flash Cyber. Vous vous demandez ce qu'est Gemini 3.6 Flash et ce dont il est capable ? Nous vous expliquons tout !
Dans cet article, nous examinons les fonctionnalités et les performances de Gemini 3.6 Flash.
TL;DR
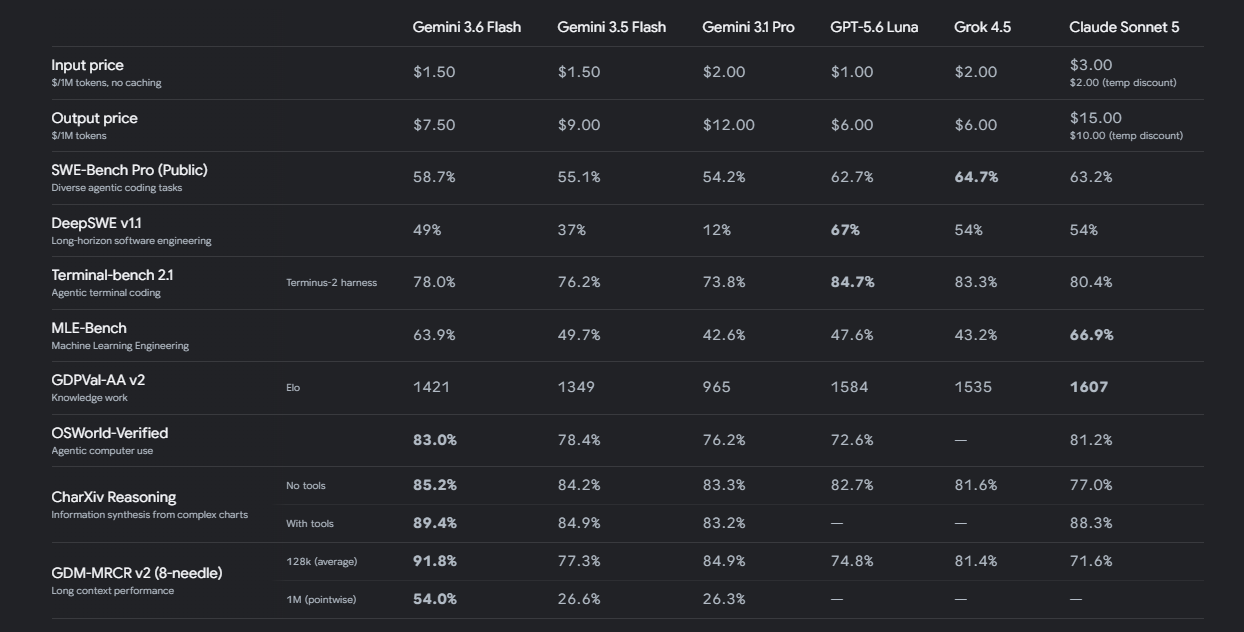
Google a lancé Gemini 3.6 Flash le 21 juillet 2026 : un modèle léger à faible latence, optimisé pour le code, le raisonnement agentique, les tâches multimodales et le travail intellectuel, avec un excellent rapport performance-prix. Il est disponible aux côtés de Gemini 3.5 Flash Lite et Gemini 3.5 Flash Cyber. Vous pouvez l'essayer gratuitement via Gemini AI, et l'accès à l'API coûte $1.5 par million de tokens en entrée et $7.5 par million de tokens en sortie. Gemini 3.6 Flash utilise 17 % de tokens en moins que Gemini 3.5 Flash, ce qui réduit les coûts globaux tout en améliorant les performances. Il intègre également l'utilisation de l'ordinateur (computer use) pour des workflows agentiques fiables et surpasse les modèles de pointe en matière d'utilisation d'outils et de travail intellectuel, même s'il reste 18 % derrière GPT-5.6 Luna sur DeepSWE v1.1. Par défaut, le modèle n'est pas conforme à l'AI Act de l'UE ni au RGPD, mais TextCortex le propose sous forme d'API conforme hébergée dans l'UE et comme moteur pour des agents IA personnalisés, des bases de connaissances et l'automatisation des workflows.
Qu'est-ce que Gemini 3.6 Flash ?
Gemini 3.6 Flash est un grand modèle de langage développé par Google et lancé le 21 juillet 2026. Par rapport à ses prédécesseurs, il offre des capacités de code avancées, un raisonnement agentique, de hautes performances sur les tâches multimodales, une faible latence et des performances fiables. Gemini 3.6 Flash vise à offrir le meilleur rapport performance-prix pour les workflows agentiques. Il a été développé à partir des retours clients et des commentaires des développeurs sur les précédents modèles Gemini.
Gemini 3.6 Flash est-il gratuit ?
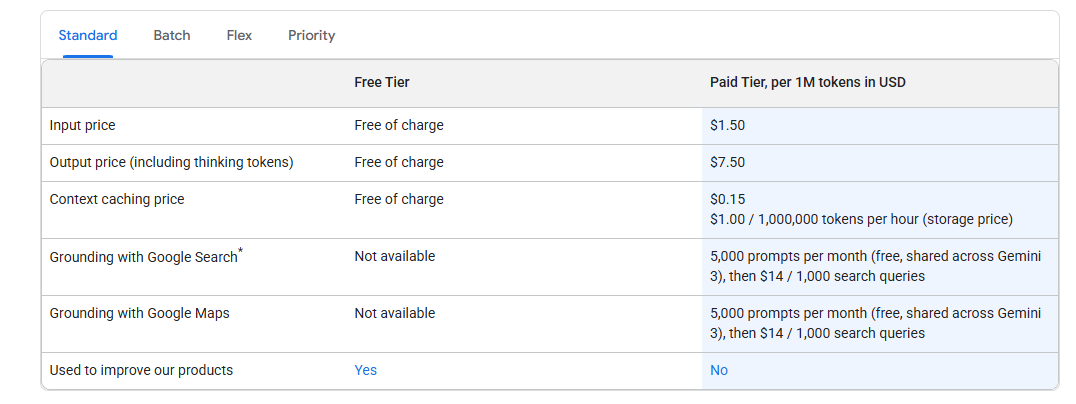
Vous pouvez utiliser et essayer gratuitement le modèle Gemini 3.6 Flash via Gemini AI. En revanche, si vous souhaitez utiliser Gemini 3.6 Flash via l'API dans les workflows de votre entreprise, vous devrez payer selon la tarification de l'API. Voici les tarifs de l'API pour le modèle Gemini 3.6 Flash :
- $1.5 par million de tokens en entrée
- $7.5 par million de tokens en sortie
Comment accéder à Gemini 3.6 Flash ?
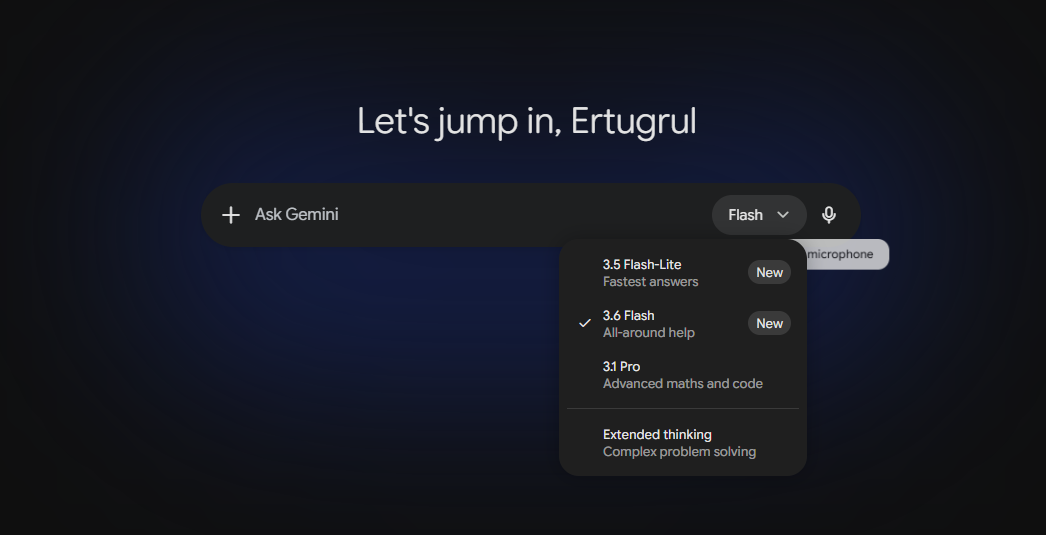
Le moyen le plus simple et le plus direct d'accéder au modèle Gemini 3.6 Flash est de passer par le chatbot Gemini AI, qui vous permet de l'utiliser gratuitement.
Vous pouvez également accéder au modèle Gemini Flash 3.6 via l'API. Mais si vous recherchez un moyen innovant et adapté aux entreprises d'accéder à Gemini Flash 3.6, vous pouvez utiliser TextCortex. TextCortex vous permet d'intégrer un large éventail de grands modèles de langage, dont Gemini Flash 3.6, dans les workflows de votre entreprise.
Gemini 3.6 Flash : fonctionnalités & performances
Le modèle Gemini 3.6 Flash apporte de nouvelles fonctionnalités, capacités et limites de performance, la plus notable étant une consommation de tokens réduite. Vous voulez connaître les fonctionnalités de Gemini 3.6 Flash ? Nous les avons listées pour vous !
Performances sur les benchmarks
Si Gemini 3.6 Flash affiche des performances nettement supérieures à celles de ses prédécesseurs sur les benchmarks, il ne surpasse pas ses concurrents sur tous. Par exemple, alors qu'il obtient un score plus élevé que ses prédécesseurs et ses concurrents sur le benchmark OSWorld-Verified, il reste 18 % derrière le modèle GPT-5.6 Luna sur le benchmark DeepSWE v1.1.
Une consommation de tokens réduite
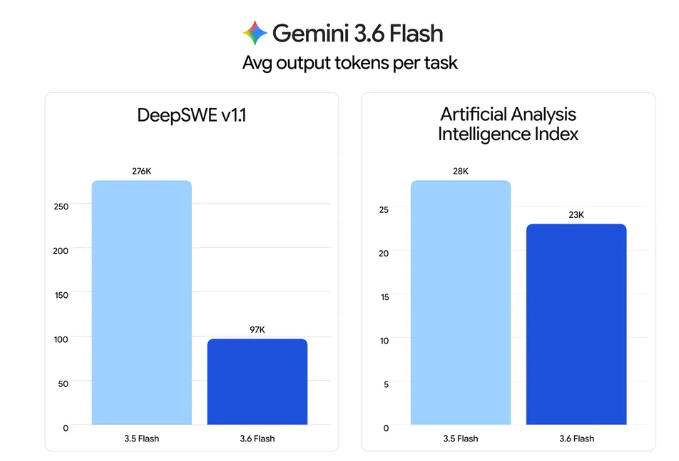
Le modèle Gemini 3.6 Flash utilise 17 % de tokens en moins pour effectuer les mêmes tâches que son prédécesseur, Gemini Flash 3.5. Selon l'article de Google, Gemini 3.6 Flash a consommé 17 % de tokens en moins que Gemini 3.5 Flash sur l'Artificial Analysis Index. Gemini 3.6 Flash vous permet donc de réduire vos coûts en consommant moins de tokens dans vos workflows automatisés. De plus, ses tarifs d'entrée et de sortie, inférieurs à ceux de son prédécesseur, augmenteront nettement vos économies. Enfin, grâce à ses performances accrues, le modèle gère plus facilement des tâches plus complexes.
De meilleures performances agentiques
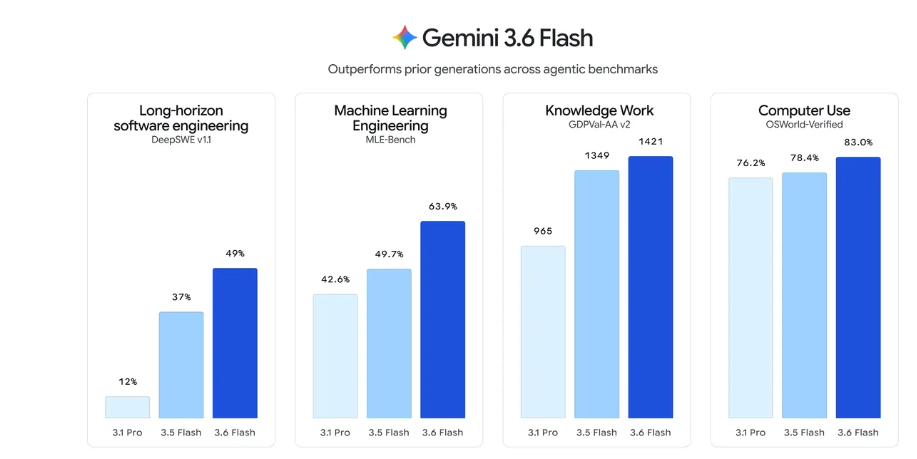
Le modèle Gemini 3.6 Flash offre des performances nettement supérieures en raisonnement agentique, travail intellectuel, utilisation d'outils et ingénierie du machine learning par rapport à ses prédécesseurs, Gemini 3.5 Flash et Gemini Pro 3.1. Ses performances agentiques en font un choix idéal pour automatiser des workflows répétitifs, complexes et en plusieurs étapes. En outre, Gemini 3.6 Flash surpasse les modèles de pointe sur les tâches agentiques impliquant l'utilisation d'outils et le travail intellectuel. Le modèle intègre aussi l'utilisation de l'ordinateur comme outil natif pour prendre en charge de manière fiable les tâches agentiques sur différentes interfaces.
TextCortex AI : intégrez Gemini 3.6 Flash dans votre entreprise
Si vous souhaitez utiliser le modèle Gemini 3.6 Flash pour automatiser les workflows de votre entreprise et améliorer votre travail intellectuel, TextCortex AI est la solution qu'il vous faut. TextCortex est une plateforme de premier plan de gestion des connaissances et d'automatisation des workflows, qui vise à alléger la charge de travail des entreprises et à leur faire gagner du temps et de l'argent. Avec TextCortex, vous pouvez utiliser un large éventail de grands modèles de langage puissants et de pointe, dont Gemini 3.6 Flash, pour automatiser ou accélérer les tâches de votre entreprise.
Accédez à Gemini 3.6 Flash hébergé dans l'UE
Par défaut, le modèle Gemini 3.6 Flash n'est pas conforme à l'AI Act de l'UE ni au RGPD. Si vous souhaitez accéder à Gemini 3.6 Flash dans le respect du RGPD, TextCortex est la solution qu'il vous faut. Avec l'API TextCortex, vous pouvez utiliser Gemini 3.6 Flash hébergé dans l'UE et conforme au RGPD. TextCortex propose des LLM de pointe, dont Gemini 3.6 Flash, ainsi que d'autres LLM économiques, hébergés dans l'UE et conformes au RGPD. Vous pouvez ainsi utiliser Gemini 3.6 Flash dans vos entreprises opérant en Europe sans aucun problème juridique.
Des agents IA propulsés par Gemini 3.6 Flash
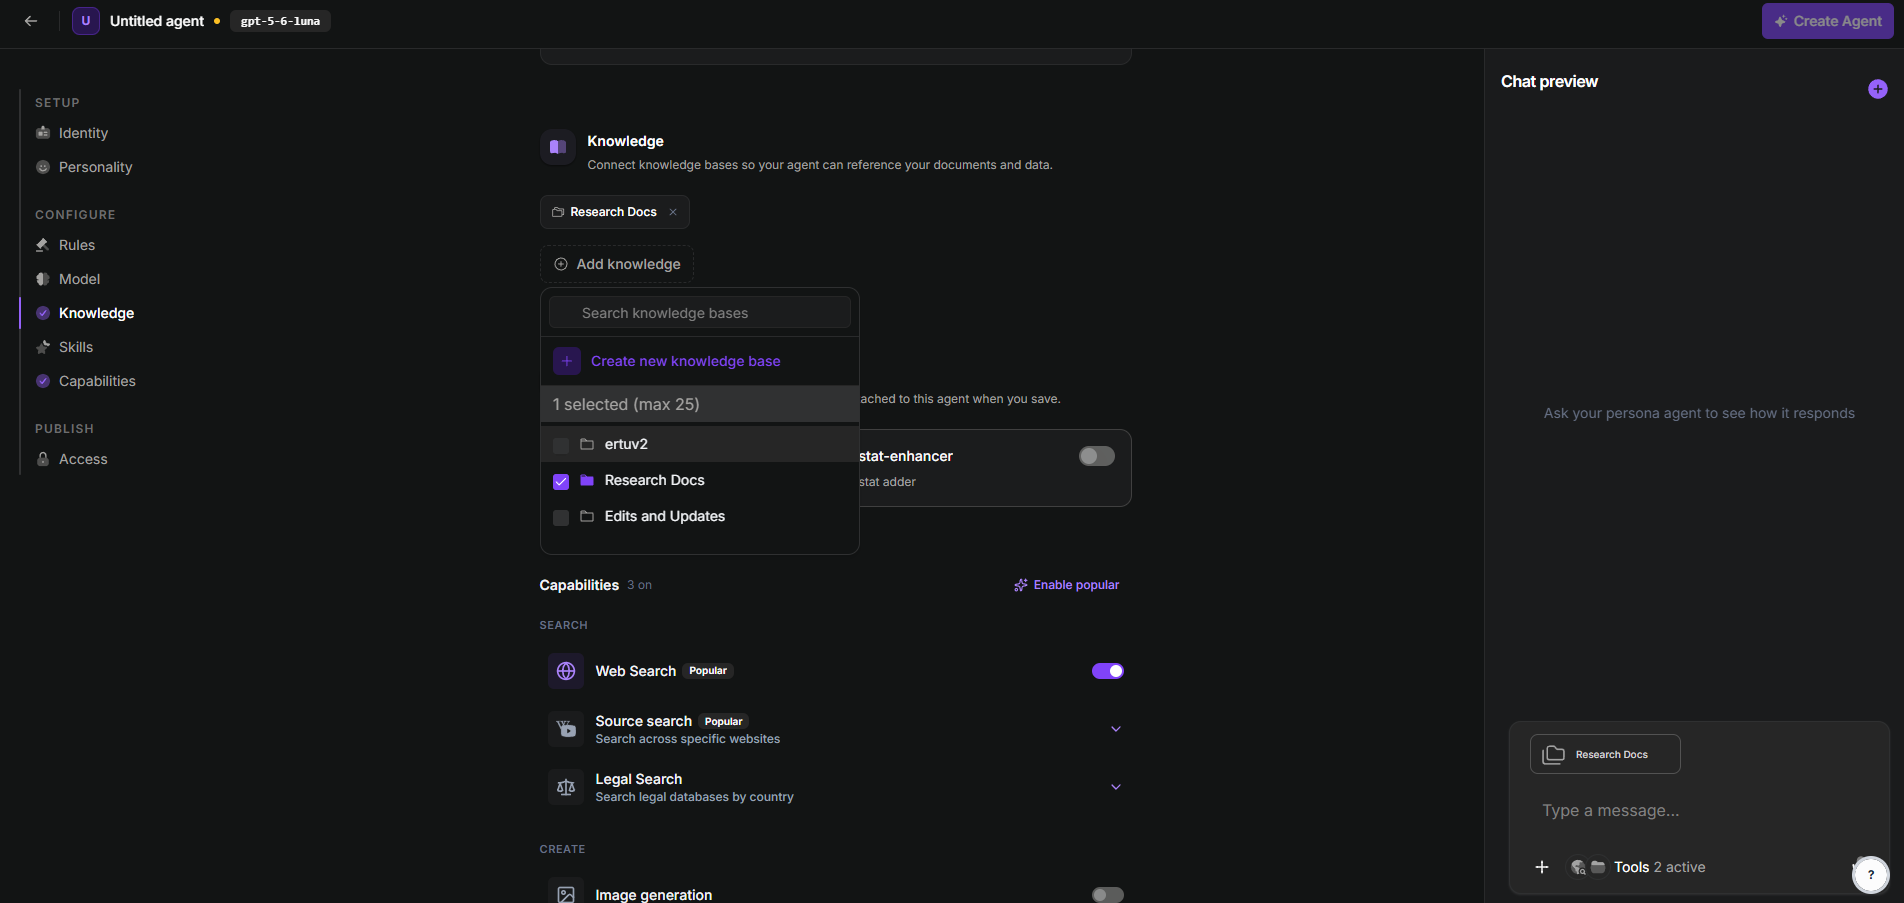
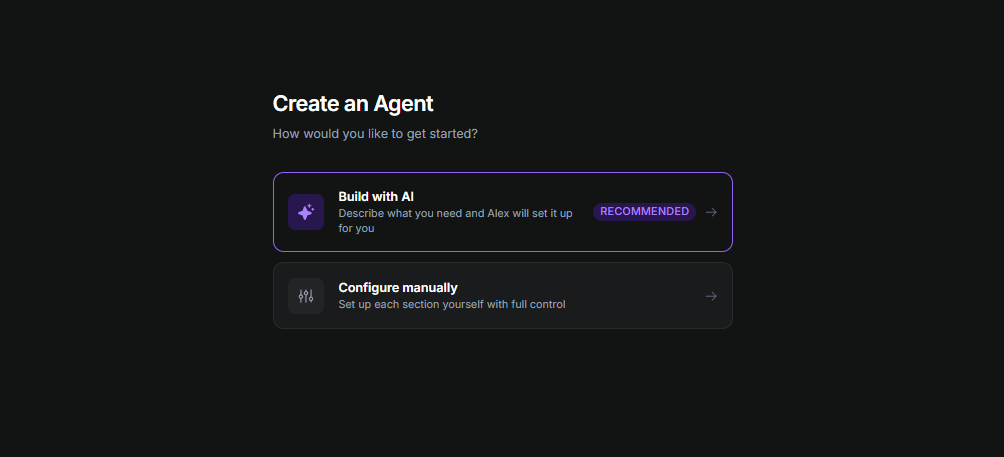
Un moyen efficace d'exploiter le modèle Gemini 3.6 Flash consiste à l'utiliser comme agent IA pour automatiser vos workflows ou simplifier vos tâches. Avec TextCortex, vous pouvez créer des agents IA personnalisés pour n'importe quelle tâche ou workflow, et même les affiner grâce à des règles de comportement modulaires appelées « skills ». Il existe deux façons de créer un agent IA avec TextCortex. La première consiste à créer l'agent IA dont vous avez besoin sous forme de conversation, avec l'aide de l'IA. La seconde est un cadre de création manuel qui vous permet de tout personnaliser, du modèle par défaut aux comportements que l'agent doit toujours ou ne jamais adopter.
Renforcez vos agents IA grâce aux bases de connaissances
TextCortex propose à ses utilisateurs des bases de connaissances dans lesquelles ils peuvent connecter leurs bases de données internes ou importer manuellement des documents. Grâce à nos bases de connaissances, vous pouvez intégrer à TextCortex les bases de données que vous utilisez pour les tâches de votre entreprise. Vous pouvez ensuite les exploiter pour le travail intellectuel ou la recherche IA via des chatbots IA. De plus, si vous souhaitez que vos agents IA TextCortex travaillent avec des bases de données spécifiques, vous pouvez leur attribuer vos bases de connaissances lors de leur création. Autre façon d'utiliser ensemble vos agents IA et vos bases de données : saisir le nom de la base de connaissances précédé du symbole "@" dans la zone de chat, par exemple "@Research Docs". Vous pouvez alors utiliser les agents IA que vous avez créés pour réaliser des tâches comme l'analyse de données, la recherche IA ou la transformation de données brutes en informations exploitables, à partir de la base de connaissances de votre choix.