La résidence des données dans l'UE désigne l'emplacement physique ou géographique où les données numériques d'une organisation sont stockées et traitées, plus précisément à l'intérieur des frontières de l'Union européenne (UE) ou de l'Espace économique européen (EEE). Pour les entreprises et les organisations, la résidence des données dans l'UE est essentielle en matière de conformité réglementaire, de souveraineté des données et de confiance des utilisateurs. Vous vous demandez ce que la résidence des données dans l'UE implique pour la stack IA d'une entreprise et quels points vérifier avant de choisir une plateforme d'IA ? Nous avons tout ce qu'il vous faut !
Dans cet article, nous expliquons ce qu'est la résidence des données dans l'UE et ce qu'elle signifie concrètement pour les stacks IA des entreprises.
TL;DR
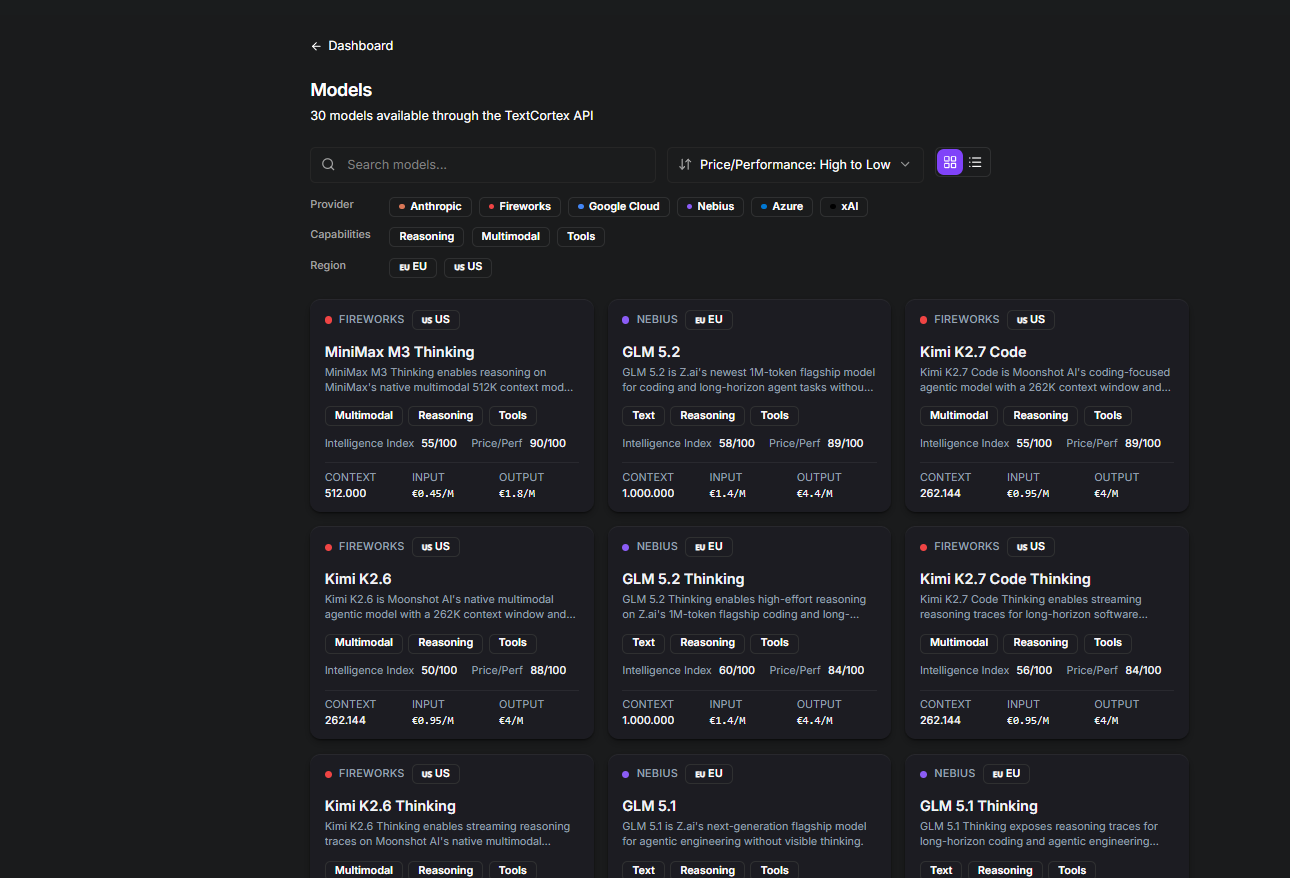
La résidence des données dans l'UE consiste à stocker et à traiter l'ensemble des données IA d'une entreprise à l'intérieur des frontières de l'UE ou de l'EEE. Cela concerne non seulement l'endroit où s'exécute le modèle, mais aussi celui où se trouvent les prompts, le contenu récupéré, le contexte et les journaux. Elle se distingue de notions voisines : la résidence porte sur l'emplacement, la souveraineté sur la juridiction applicable et la conformité sur le respect des exigences de gouvernance. Pour évaluer correctement les promesses d'une plateforme d'IA en matière de résidence, examinez quatre surfaces : l'inférence (où les prompts sont traités et les réponses générées), les index de recherche (où les connaissances de l'entreprise sont indexées et les embeddings stockés), la fenêtre de contexte (comment l'historique des conversations, la mémoire et les fichiers joints sont conservés et gérés) et les journaux de raisonnement (métadonnées opérationnelles, traces d'outils et enregistrements d'observabilité). Un fournisseur qui se dit « hébergé en Europe » sans clarifier ces quatre couches laisse des failles de conformité. TextCortex couvre les quatre surfaces et propose, via une API unique, plus de 24 LLM hébergés dans l'UE et conformes au RGPD (dont GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro et des alternatives économiques comme Kimi K2.6, GLM 5.2 et DeepSeek V4 Pro), avec supervision, journalisation et audit intégrés, des agents IA et des bases de connaissances pour l'entreprise.
Ce que signifie la résidence des données dans l'UE pour l'IA
La résidence des données IA dans l'UE est le moyen le plus rapide pour les organisations et les entreprises d'utiliser l'IA générative, les agents IA et les modèles d'IA sans compromettre la protection des données. Pour l'IA, la résidence des données dans l'UE ne se limite pas au stockage des données du modèle sur des serveurs hébergés dans l'UE : elle exige aussi que toutes les données d'entrée et de sortie du modèle soient traitées à l'intérieur des frontières de l'UE ou de l'EEE.
Pourquoi la résidence des données dans l'UE est-elle importante ?
L'essentiel, avec la résidence des données dans l'UE, est de garantir que les flux de données des entreprises et des organisations restent à l'intérieur des frontières de l'UE à chaque étape du workflow, afin d'éviter toute fuite de données. La résidence des données dans l'UE protège les informations sensibles de l'organisation ou de l'entreprise, notamment les prompts, le contenu récupéré, les journaux, les réponses et les autres données utilisées ou générées par l'IA. En tant qu'utilisateur, vous pouvez ainsi suivre et cartographier précisément où les données de votre organisation sont traitées, stockées et journalisées.
Résidence des données, souveraineté et conformité : quelles différences ?
À première vue, résidence des données, souveraineté et conformité peuvent sembler désigner la même chose, mais il s'agit de facettes différentes de questions proches. Voici, en bref, ce qui distingue ces trois notions :
- Résidence des données : l'endroit où les données sont stockées ou traitées.
- Souveraineté des données : la juridiction qui peut s'appliquer à ces données.
- Conformité : le fait que l'ensemble du dispositif réponde ou non aux exigences légales et de gouvernance.
Si l'hébergement dans l'UE est important pour les plateformes d'IA, il ne représente qu'une partie du tableau.
Les 4 surfaces de la résidence des données IA dans l'UE
La résidence des données IA ne se résume pas à l'endroit où l'application est hébergée. Elle couvre aussi le lieu de traitement des prompts, le lieu d'indexation des données de l'entreprise, la quantité de contexte conservée et ce qui est écrit dans les journaux. C'est pourquoi la manière la plus fiable d'évaluer la résidence d'une IA consiste à examiner 4 surfaces : l'inférence, la recherche, le contexte et les journaux.
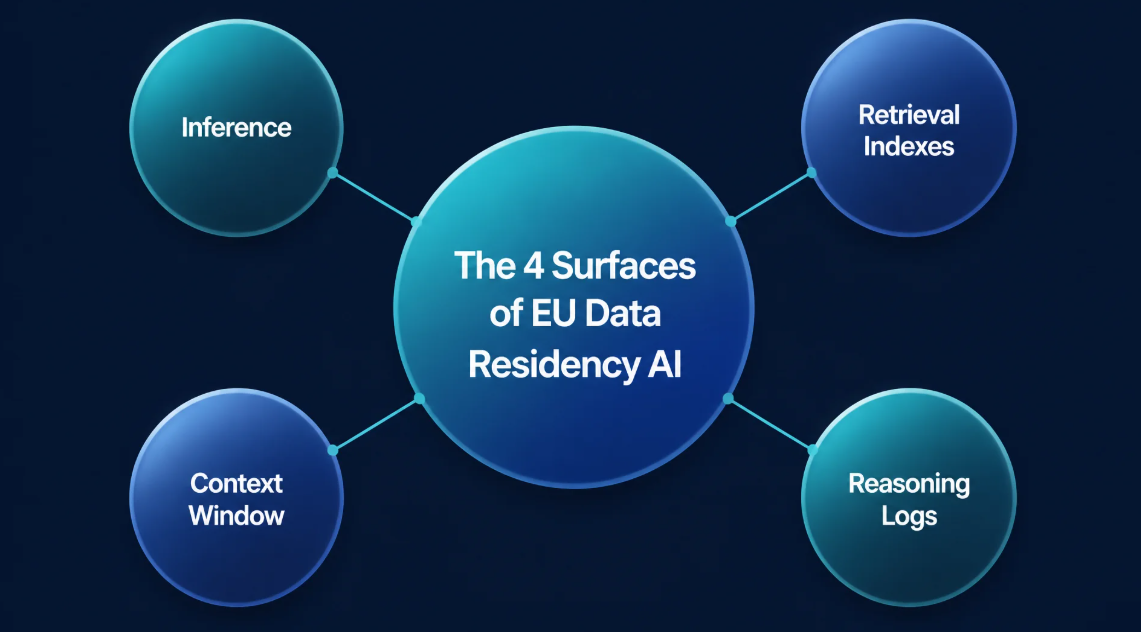
Couche 1 : l'inférence
C'est le moment où un utilisateur saisit un prompt, où le modèle le traite et où la réponse est générée. Autrement dit, c'est lors de l'inférence que votre requête devient réellement une réponse. Si vous évaluez une plateforme d'IA pour un usage en entreprise, c'est l'un des premiers points à vérifier. L'inférence peut porter sur des documents internes, des données clients, des questions juridiques, des notes stratégiques ou des détails opérationnels. Si la couche d'inférence manque de clarté, l'ensemble de votre déploiement d'IA devient plus difficile à gouverner. C'est pourquoi l'inférence ne doit jamais se réduire à une formule marketing comme « hébergé en Europe ». Vous avez besoin d'une réponse claire sur l'endroit où les requêtes sont traitées, sur la circulation des données pendant la génération et sur la conservation éventuelle des données des prompts une fois la réponse produite.
Couche 2 : les index de recherche
La deuxième surface concerne les index de recherche. Si l'IA peut accéder à vos connaissances, vous devez savoir où ces connaissances sont indexées. De nombreux outils d'IA pour l'entreprise ne se contentent pas de générer des réponses à partir d'un prompt. Ils se connectent aussi aux données de l'entreprise : documents internes, wikis, articles d'assistance, PDF, notes de réunion ou espaces de stockage cloud. Pour rendre ces informations consultables, la plateforme crée souvent des index. C'est là que beaucoup d'acheteurs perdent de vue la situation d'ensemble. Un fournisseur peut affirmer que son chat est hébergé dans l'UE, mais si la couche de recherche stocke ailleurs les données indexées de l'entreprise, la question de la résidence n'est pas entièrement réglée. Vous devez savoir où se trouvent ces index, où sont stockés les embeddings, où le contenu synchronisé est traité et si les sources connectées restent dans la région prévue.
Pourquoi est-ce important ?
Parce que les index de recherche contiennent souvent la structure des connaissances de votre entreprise. Ils ne ressemblent pas forcément au document d'origine, mais ils représentent tout de même des données d'entreprise. Si votre assistant IA peut effectuer des recherches dans les politiques RH, le contenu du support client, les modèles juridiques ou la documentation produit, la couche de recherche devient un élément majeur de votre examen de conformité et de gouvernance.
Couche 3 : la fenêtre de contexte
La troisième surface est la fenêtre de contexte. C'est la couche qui assure la continuité des systèmes d'IA. Elle regroupe les informations transmises dans une session pour que le modèle puisse générer une réponse plus pertinente. Selon la plateforme, il peut s'agir de l'historique récent des conversations, des instructions de l'espace de travail, de la mémoire, des paramètres des agents, des fichiers joints et du contexte propre à chaque utilisateur.
Pourquoi est-ce important ?
Parce que c'est le contexte qui rend l'IA d'entreprise vraiment utile. Il aide le système à comprendre ce que demande votre équipe, sur quelles données s'appuyer et comment répondre. Mais le contexte peut aussi contenir des éléments sensibles qu'il faut gérer avec soin. Vous devez donc savoir combien de temps les historiques de conversation sont conservés, si les administrateurs peuvent contrôler la durée de conservation et si la mémoire est limitée par espace de travail, par utilisateur ou par projet.
Couche 4 : les journaux de raisonnement
Dernière surface, mais non des moindres : les journaux de raisonnement. Il s'agit des enregistrements produits autour du traitement d'une requête d'IA. Selon la plateforme, ils peuvent inclure des métadonnées d'utilisation, des traces d'outils, des enregistrements de débogage, les étapes du workflow, des horodatages, des journaux d'erreurs, des événements de supervision et d'autres données d'observabilité. Cette surface est facile à négliger, alors qu'elle compte parmi les plus importantes.
Pourquoi est-ce important ?
Parce que même lorsqu'un fournisseur limite la conservation des prompts, les journaux opérationnels peuvent encore capturer des informations significatives sur l'utilisation du système. Pour les entreprises clientes, cela touche à l'auditabilité, à la réponse aux incidents, aux revues de sécurité et à la gouvernance interne. Une plateforme peut sembler solide au niveau de l'interface, mais si ses journaux de raisonnement sont flous, sans restriction ou mal documentés, les équipes de sécurité s'en apercevront. C'est pourquoi les fournisseurs d'IA d'entreprise matures doivent être transparents non seulement sur l'endroit où les réponses sont générées, mais aussi sur la façon dont l'ensemble du cycle de vie d'une requête est supervisé et enregistré.
TextCortex AI : fournisseur européen de modèles de pointe et solution d'IA pour l'entreprise
Si vous recherchez un fournisseur d'IA européen et une plateforme d'outils d'IA pour l'entreprise qui couvre tous les niveaux de résidence des données dans l'UE, TextCortex est la solution qu'il vous faut. TextCortex est une plateforme qui vise à répondre aux besoins des entreprises en matière d'IA en proposant à ses utilisateurs des modèles d'IA de pointe hébergés dans l'UE et conformes au RGPD. Avec TextCortex, vous pouvez utiliser plus de 24 grands modèles de langage via une API unique, dans le respect de la résidence des données dans l'UE. TextCortex offre en outre à ses utilisateurs des fonctions de supervision, de journalisation et d'audit, pour que vous gardiez toujours le contrôle de vos modèles d'IA. Examinons de plus près les fonctionnalités de TextCortex.
Accès à des LLM hébergés dans l'UE
TextCortex permet aux utilisateurs d'exploiter 30 modèles différents via une API unique, tous hébergés dans l'UE et conformes au RGPD. Parmi eux figurent des modèles d'IA de pointe comme GPT-5.5, Claude Opus 4.7 et Gemini 3.1 Pro, ainsi que des options alternatives et économiques comme KimiK2.6, GLM 5.2 et DeepSeek V4 Pro.
Une IA d'entreprise hébergée dans l'UE
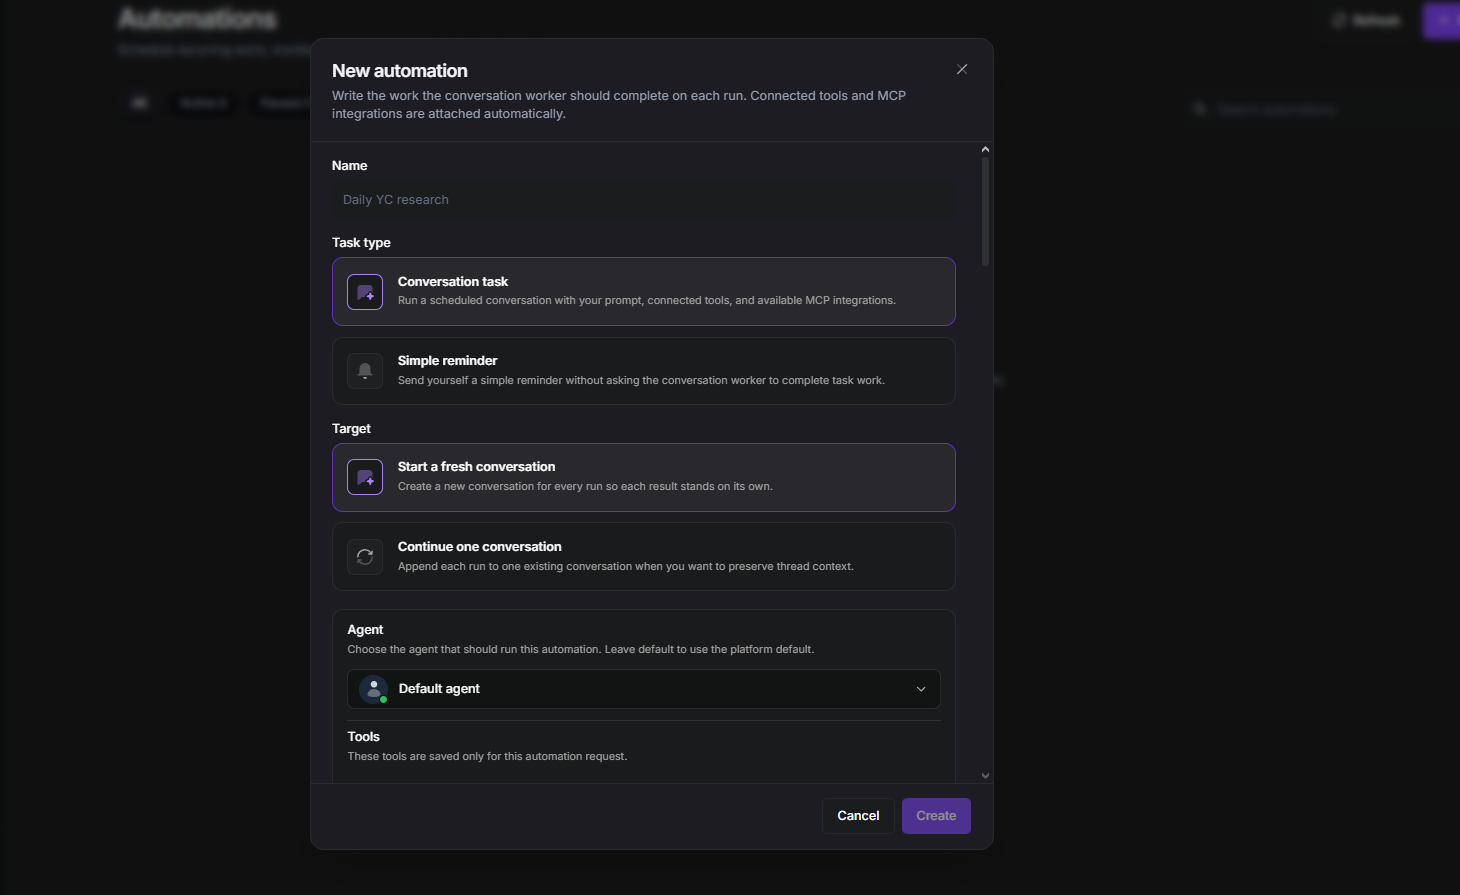
En plus d'être un fournisseur de LLM, TextCortex propose à ses utilisateurs une plateforme d'IA d'entreprise hébergée dans l'UE et conforme au RGPD. Avec TextCortex, vous pouvez automatiser des workflows complexes et répétitifs ou améliorer votre gestion des connaissances grâce à un large choix de LLM. Le framework d'agents IA de TextCortex vous permet de créer des agents d'automatisation pour des tâches spécifiques. De plus, grâce à nos bases de connaissances, vous pouvez intégrer vos bases de données internes à TextCortex pour accéder aux informations dont vous avez besoin sous forme conversationnelle ou transformer vos données brutes en résultats exploitables.
Questions fréquentes
Qu'est-ce que la résidence des données dans l'UE pour l'IA ?
Elle désigne l'endroit où les données liées à l'IA sont traitées, stockées, indexées ou journalisées dans l'ensemble de la stack IA.
L'hébergement dans l'UE équivaut-il à la souveraineté de l'IA ?
Non. L'hébergement dans l'UE concerne l'emplacement. La souveraineté englobe aussi la juridiction, la gouvernance, le contrôle et l'indépendance opérationnelle.
Que doivent vérifier les entreprises au-delà du lieu d'inférence ?
Elles doivent également vérifier la recherche, le contexte et les journaux.
Un outil d'IA peut-il être conforme au RGPD s'il fait appel à des fournisseurs de modèles américains ?
Cela dépend de l'architecture, des contrats, des garanties, des flux de données et des contrôles de gouvernance. Les acheteurs doivent vérifier l'ensemble de la chaîne de traitement.