Nach Anthropic und OpenAI hat nun auch Google ein Modell angekündigt, das bei Coding, Wissensarbeit und agentischem Reasoning hohe Leistung bei geringerem Token-Verbrauch liefert: Gemini 3.6 Flash. Gemini 3.6 Flash ist sowohl als API als auch über Gemini AI verfügbar und erscheint zusammen mit den Modellen 3.5 Flash Lite und 3.5 Flash Cyber. Wenn Sie wissen möchten, was Gemini 3.6 Flash ist und was es kann, sind Sie hier genau richtig!
In diesem Artikel sehen wir uns die Funktionen und die Leistung von Gemini 3.6 Flash genauer an.
TL;DR
Google hat Gemini 3.6 Flash am 21. Juli 2026 veröffentlicht: ein schlankes Modell mit niedriger Latenz, optimiert für Coding, agentisches Reasoning, multimodale Aufgaben und Wissensarbeit bei einem starken Preis-Leistungs-Verhältnis. Es ist zusammen mit Gemini 3.5 Flash Lite und Gemini 3.5 Flash Cyber erhältlich. Sie können es kostenlos über Gemini AI testen; der API-Zugang kostet $1.5 pro Million Input-Token und $7.5 pro Million Output-Token. Gemini 3.6 Flash verbraucht 17 % weniger Token als Gemini 3.5 Flash und senkt so die Gesamtkosten bei besserer Leistung. Zudem bietet es integrierte Computer Use für zuverlässige agentische Workflows und übertrifft Frontier-Modelle bei Tool-Nutzung und Wissensarbeit, liegt auf DeepSWE v1.1 jedoch noch 18 % hinter GPT-5.6 Luna. Standardmäßig ist das Modell nicht konform mit dem EU AI Act oder der DSGVO, doch TextCortex bietet es als in der EU gehostete, konforme API und als Grundlage für individuelle KI-Agenten, Wissensdatenbanken und Workflow-Automatisierung an.
Was ist Gemini 3.6 Flash?
Gemini 3.6 Flash ist ein Large Language Model von Google, das am 21. Juli 2026 veröffentlicht wurde. Im Vergleich zu seinen Vorgängern bietet es fortschrittliches Coding, agentisches Reasoning, hohe Leistung bei multimodalen Aufgaben, niedrige Latenz und zuverlässige Ergebnisse. Gemini 3.6 Flash soll das optimale Preis-Leistungs-Verhältnis für agentische Workflows bieten. Entwickelt wurde es auf Basis von Kundenfeedback und Entwicklerrückmeldungen zu früheren Gemini-Modellen.
Ist Gemini 3.6 Flash kostenlos?
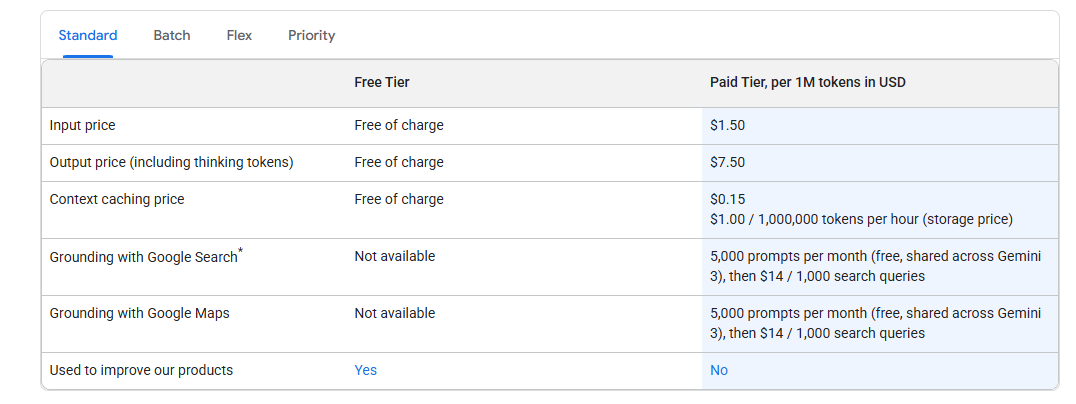
Über Gemini AI können Sie das Modell Gemini 3.6 Flash kostenlos nutzen und ausprobieren. Wenn Sie Gemini 3.6 Flash jedoch als API in Ihren Unternehmens-Workflow einbinden möchten, fallen die API-Preise an. Die API-Preise für Gemini 3.6 Flash sind wie folgt:
- $1.5 pro Million Input-Token
- $7.5 pro Million Output-Token
Wie erhalten Sie Zugriff auf Gemini 3.6 Flash?
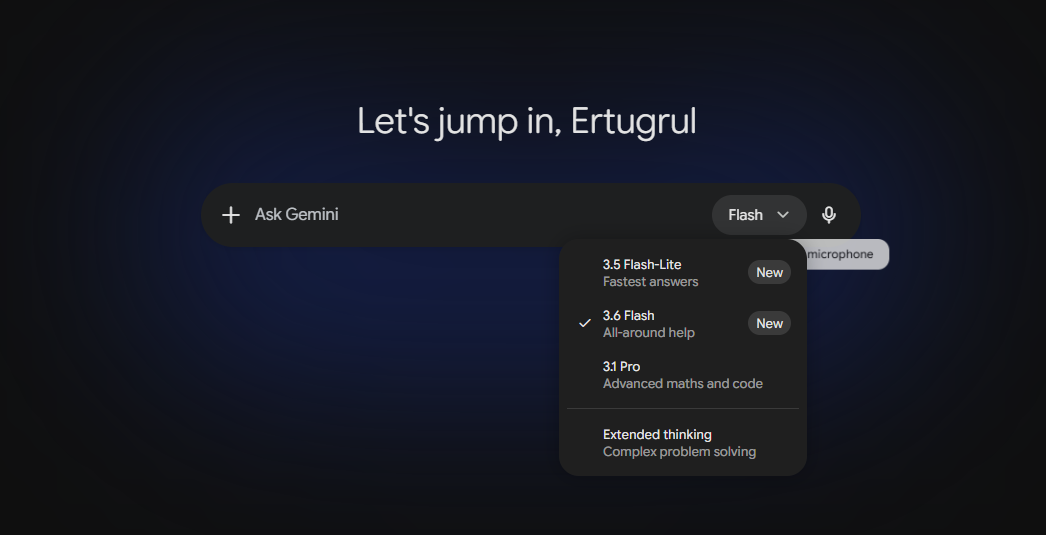
Am einfachsten und direktesten nutzen Sie das Modell Gemini 3.6 Flash über den Chatbot Gemini AI. Dort steht Ihnen Gemini 3.6 Flash kostenlos zur Verfügung.
Eine weitere Möglichkeit ist die Nutzung von Gemini Flash 3.6 als API. Wenn Sie jedoch einen innovativen, auf Unternehmen ausgerichteten Zugang zu Gemini Flash 3.6 suchen, können Sie TextCortex verwenden. Mit TextCortex integrieren Sie eine Vielzahl von Large Language Models, darunter Gemini Flash 3.6, in Ihre Unternehmens-Workflows.
Gemini 3.6 Flash: Funktionen & Leistung
Das Modell Gemini 3.6 Flash bringt neue Funktionen, Fähigkeiten und Leistungsgrenzen mit sich – allen voran einen geringeren Token-Verbrauch. Wenn Sie wissen möchten, was Gemini 3.6 Flash zu bieten hat, haben wir die Funktionen für Sie zusammengestellt!
Benchmark-Leistung
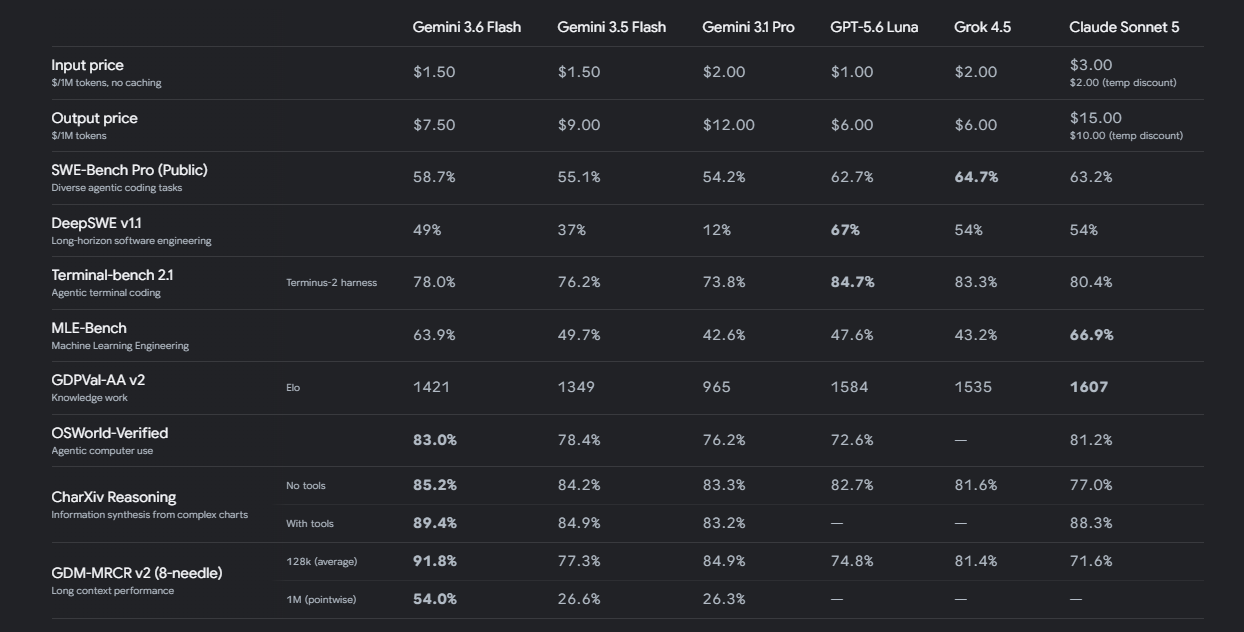
Gemini 3.6 Flash erzielt zwar deutlich bessere Benchmark-Ergebnisse als seine Vorgänger, übertrifft die Konkurrenz aber nicht in jedem Benchmark. So schneidet Gemini 3.6 Flash im Benchmark OSWorld-Verified besser ab als seine Vorgänger und Wettbewerber, liegt im Benchmark DeepSWE v1.1 jedoch 18 % hinter dem Modell GPT-5.6 Luna.
Geringerer Token-Verbrauch
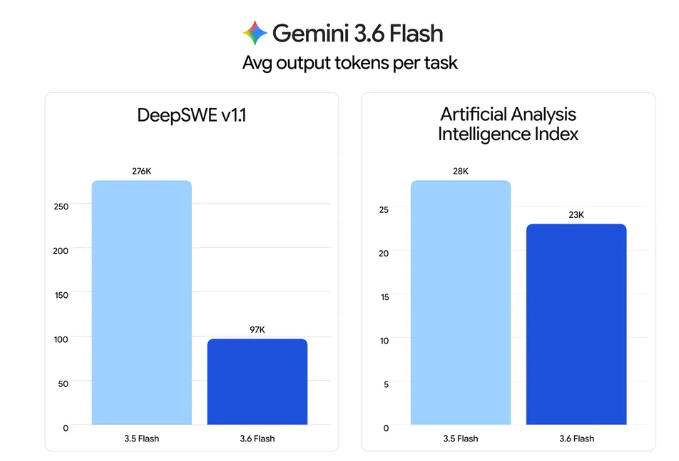
Gemini 3.6 Flash benötigt für dieselben Aufgaben 17 % weniger Token als sein Vorgänger Gemini Flash 3.5. Laut Googles Artikel verbrauchte Gemini 3.6 Flash im Artificial Analysis Index 17 % weniger Token als Gemini 3.5 Flash. Damit können Sie mit Gemini 3.6 Flash Kosten sparen, weil Ihre automatisierten Workflows weniger Token verbrauchen. Hinzu kommt, dass die im Vergleich zum Vorgänger niedrigeren Input- und Output-Preise Ihre Ersparnis deutlich erhöhen. Und dank der höheren Leistung bewältigt das Modell auch komplexere Aufgaben mühelos.
Bessere agentische Leistung
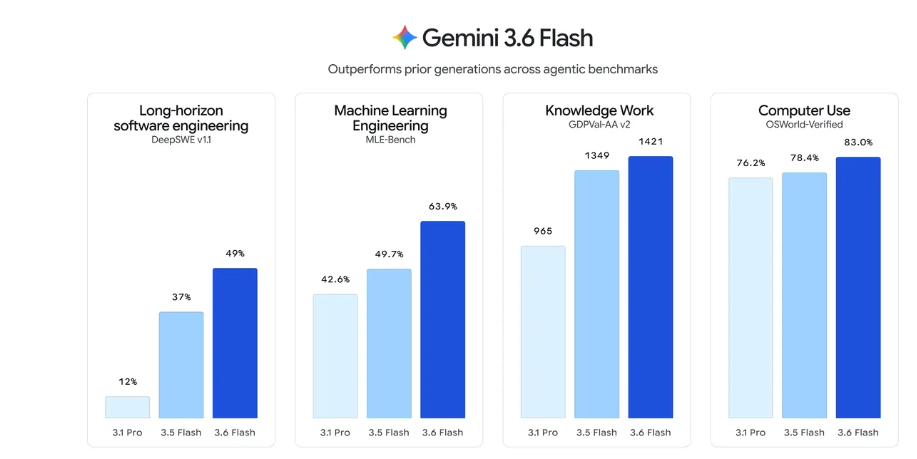
Gemini 3.6 Flash bietet deutlich bessere Leistung bei agentischem Reasoning, Wissensarbeit, Tool-Nutzung und Machine-Learning-Engineering als seine Vorgänger Gemini 3.5 Flash und Gemini Pro 3.1. Dank dieser agentischen Leistung eignet sich Gemini 3.6 Flash ideal für die Automatisierung repetitiver, mehrstufiger und komplexer Workflows. Darüber hinaus übertrifft Gemini 3.6 Flash Frontier-Modelle bei agentischen Aufgaben mit Tool-Nutzung und Wissensarbeit. Außerdem verfügt das Modell über Computer Use als integriertes Tool, um agentische Aufgaben über verschiedene Oberflächen hinweg zuverlässig zu unterstützen.
TextCortex AI: Gemini 3.6 Flash in Ihrem Unternehmen einsetzen
Wenn Sie Gemini 3.6 Flash nutzen möchten, um Ihre Unternehmens-Workflows zu automatisieren und Ihre Wissensarbeit zu verbessern, ist TextCortex AI die Lösung, die Sie suchen. TextCortex ist eine führende Plattform für Wissensmanagement und Workflow-Automatisierung, die Unternehmen entlastet und ihnen Zeit und Kosten spart. Mit TextCortex können Sie eine Vielzahl leistungsstarker Frontier-LLMs, darunter Gemini 3.6 Flash, nutzen, um Ihre Unternehmensaufgaben zu automatisieren oder zu beschleunigen.
Gemini 3.6 Flash in der EU gehostet nutzen
Standardmäßig ist Gemini 3.6 Flash nicht konform mit dem EU AI Act und der DSGVO. Wenn Sie Gemini 3.6 Flash DSGVO-konform nutzen möchten, ist TextCortex die richtige Lösung für Sie. Mit der TextCortex API können Sie Gemini 3.6 Flash in der EU gehostet und DSGVO-konform verwenden. TextCortex bietet Frontier-LLMs wie Gemini 3.6 Flash sowie weitere kosteneffiziente LLMs in der EU gehostet und DSGVO-konform an. So können Sie Gemini 3.6 Flash in Ihren in Europa tätigen Unternehmen ohne rechtliche Probleme einsetzen.
KI-Agenten mit Gemini 3.6 Flash
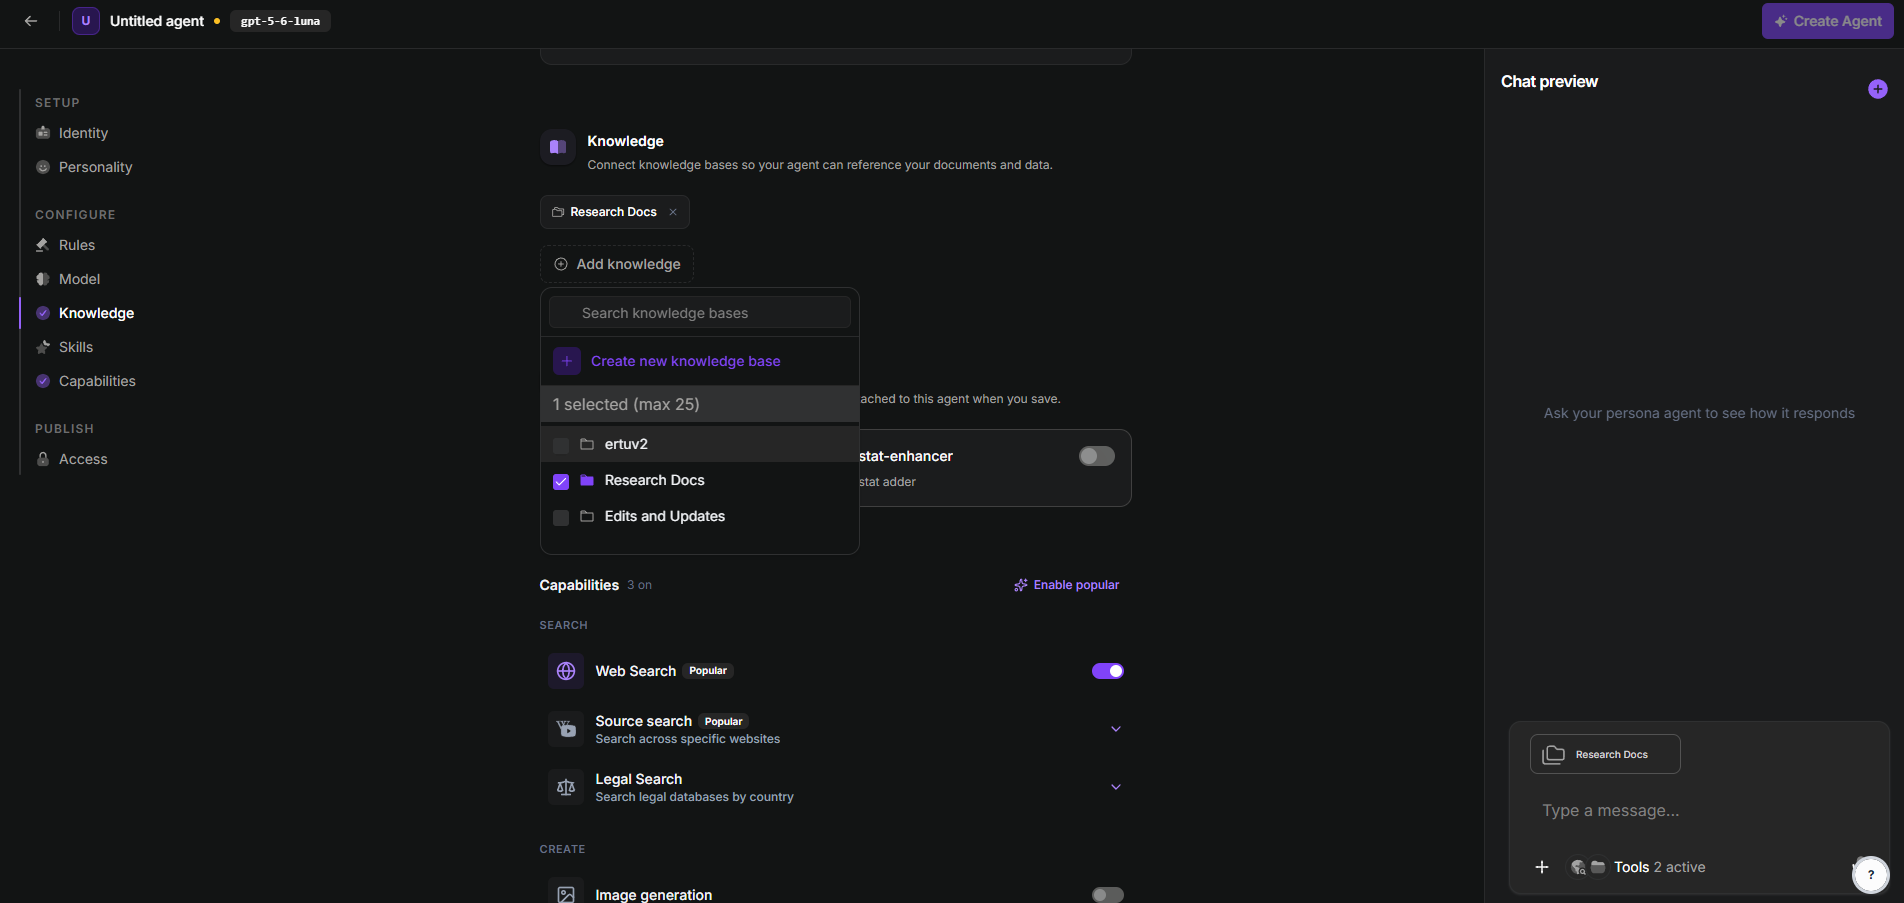
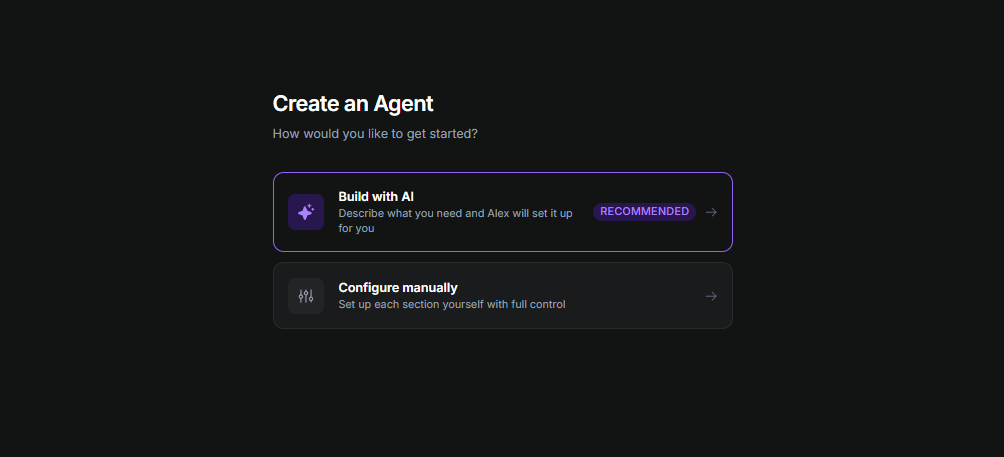
Eine effektive Möglichkeit, Gemini 3.6 Flash zu nutzen, besteht darin, es als KI-Agent einzusetzen, um Ihre Workflows zu automatisieren oder Ihre Aufgaben zu optimieren. Mit TextCortex können Sie individuelle KI-Agenten für jede Aufgabe und jeden Workflow erstellen und sie sogar mit modularen Verhaltensregeln, sogenannten „Skills“, feinabstimmen. Es gibt zwei Wege, mit TextCortex einen KI-Agenten zu erstellen. Beim ersten erstellen Sie den benötigten KI-Agenten im Dialog mit KI-Unterstützung. Die zweite Methode ist ein manuelles Framework, mit dem Sie alles anpassen können – vom Standardmodell bis zu den Verhaltensweisen, die der Agent immer oder niemals ausführen soll.
Stärken Sie Ihre KI-Agenten mit Wissensdatenbanken
TextCortex bietet seinen Nutzern Wissensdatenbanken, mit denen sie ihre internen Datenbanken verbinden oder Dokumente manuell hochladen können. Mit unseren Wissensdatenbanken integrieren Sie die Datenbanken, die Sie für Ihre Unternehmensaufgaben nutzen, in TextCortex. Anschließend können Sie diese Datenbanken über KI-Chatbots für Wissensarbeit oder KI-Suche verwenden. Wenn Ihre TextCortex-KI-Agenten mit bestimmten Datenbanken arbeiten sollen, können Sie ihnen Ihre Wissensdatenbanken außerdem bereits bei der Erstellung zuweisen. Eine weitere Möglichkeit, KI-Agenten und Datenbanken gemeinsam zu nutzen, besteht darin, während der Nutzung den Namen der Wissensdatenbank mit dem Symbol "@" in das Chatfeld einzugeben, zum Beispiel "@Research Docs". Anschließend können Sie Ihre erstellten KI-Agenten nutzen, um mit der gewünschten Wissensdatenbank Aufgaben wie Datenanalyse, KI-Suche oder die Umwandlung von Rohdaten in Erkenntnisse zu erledigen.