EU-Datenresidenz bezeichnet den physischen bzw. geografischen Ort, an dem die digitalen Daten einer Organisation gespeichert und verarbeitet werden – konkret innerhalb der Grenzen der Europäischen Union (EU) oder des Europäischen Wirtschaftsraums (EWR). Für Unternehmen und Organisationen ist EU-Datenresidenz wichtig für die Einhaltung regulatorischer Vorgaben, die Datensouveränität und das Vertrauen der Nutzer. Wenn Sie wissen möchten, was EU-Datenresidenz für den KI-Stack eines Unternehmens bedeutet und welche Punkte Sie vor der Wahl einer KI-Plattform prüfen sollten, sind Sie hier genau richtig!
In diesem Artikel erklären wir, was EU-Datenresidenz ist und was sie für KI-Stacks in Unternehmen tatsächlich bedeutet.
TL;DR
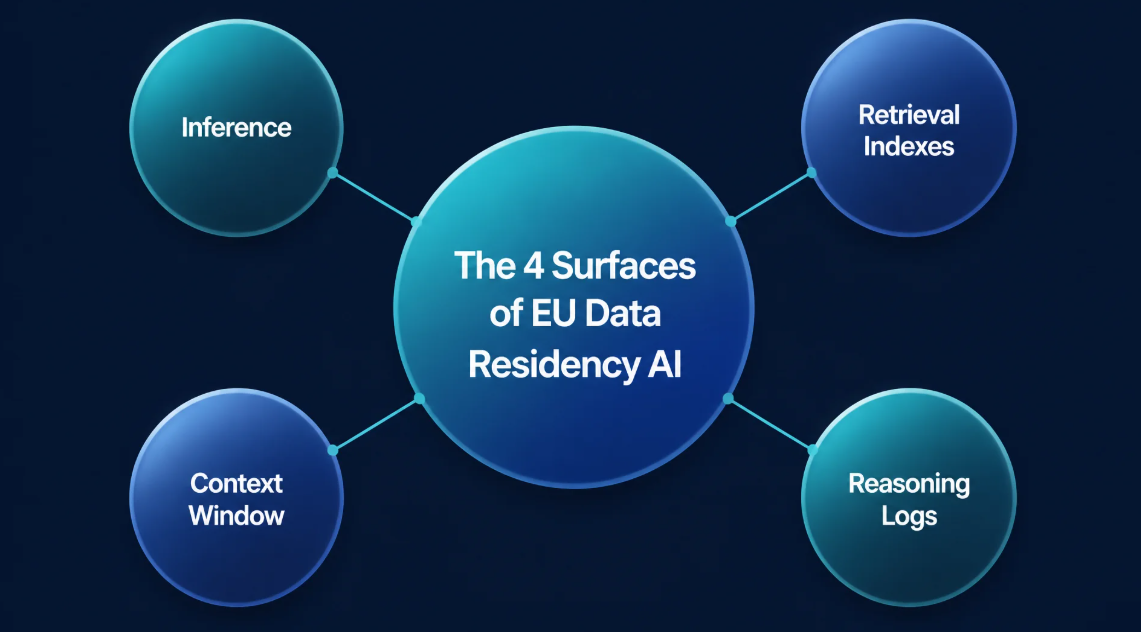
EU-Datenresidenz bedeutet, dass sämtliche KI-Daten eines Unternehmens innerhalb der Grenzen der EU oder des EWR gespeichert und verarbeitet werden. Dabei geht es nicht nur darum, wo das Modell läuft, sondern auch darum, wo Prompts, abgerufene Inhalte, Kontext und Logs liegen. Der Begriff unterscheidet sich von verwandten Konzepten: Bei Residenz geht es um den Standort, bei Souveränität um die rechtliche Zuständigkeit und bei Compliance um die Erfüllung von Governance-Anforderungen. Um die Residenzversprechen einer KI-Plattform richtig zu bewerten, sollten Sie vier Ebenen prüfen: Inferenz (wo Prompts verarbeitet und Ausgaben erzeugt werden), Retrieval-Indizes (wo Unternehmenswissen indexiert und Embeddings gespeichert werden), Kontextfenster (wie Gesprächsverlauf, Gedächtnis und angehängte Dateien aufbewahrt und verwaltet werden) und Reasoning-Logs (operative Metadaten, Tool-Traces und Observability-Aufzeichnungen). Ein Anbieter, der mit „in Europa gehostet“ wirbt, ohne alle vier Ebenen klar offenzulegen, hinterlässt Compliance-Lücken. TextCortex deckt alle vier Ebenen ab und bietet über eine einzige API mehr als 24 in der EU gehostete, DSGVO-konforme LLMs (darunter GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro sowie günstige Alternativen wie Kimi K2.6, GLM 5.2 und DeepSeek V4 Pro) – mit integriertem Monitoring, Logging und Auditing, KI-Agenten und Wissensdatenbanken für Unternehmen.
Was EU-Datenresidenz für KI bedeutet
KI-Datenresidenz in der EU ist für Organisationen und Unternehmen der schnellste Weg, generative KI, KI-Agenten und KI-Modelle zu nutzen, ohne beim Datenschutz Abstriche zu machen. EU-Datenresidenz für KI beschränkt sich nicht darauf, Modelldaten auf in der EU gehosteten Servern zu speichern; sie verlangt auch, dass alle Eingabe- und Ausgabedaten des Modells innerhalb der Grenzen der EU oder des EWR verarbeitet werden.
Warum ist EU-Datenresidenz wichtig?
Der Kern der EU-Datenresidenz besteht darin, sicherzustellen, dass der Datenfluss in Unternehmen und Organisationen bei jedem Schritt des Workflows innerhalb der EU-Grenzen bleibt, und so Datenabflüsse zu verhindern. EU-Datenresidenz schützt sensible Organisations- und Geschäftsinformationen, darunter Prompts, abgerufene Inhalte, Logs, Ausgaben und andere Daten, die von KI genutzt oder erzeugt werden. So können Sie als Nutzer klar nachverfolgen und dokumentieren, wo die Daten Ihrer Organisation verarbeitet, gespeichert und protokolliert werden.
Datenresidenz, Datensouveränität und Compliance: der Unterschied
Auf den ersten Blick scheinen Datenresidenz, Datensouveränität und Compliance dasselbe zu meinen, doch sie beschreiben unterschiedliche Aspekte verwandter Fragen. Den Unterschied zwischen diesen drei Begriffen können wir kurz so zusammenfassen:
- Datenresidenz: Wo Daten gespeichert oder verarbeitet werden.
- Datensouveränität: Welche Rechtsordnung auf diese Daten Einfluss haben kann.
- Compliance: Ob das gesamte Setup die rechtlichen und Governance-Anforderungen erfüllt.
Hosting in der EU ist für KI-Plattformen zwar wichtig, aber nur ein Teil des Gesamtbilds.
Die 4 Ebenen der EU-Datenresidenz für KI
Bei KI-Datenresidenz geht es nicht nur darum, wo die Anwendung gehostet wird. Dazu gehört auch, wo Prompts verarbeitet werden, wo Unternehmensdaten indexiert werden, wie viel Kontext aufbewahrt wird und was in Logs geschrieben wird. Deshalb lässt sich KI-Datenresidenz am besten anhand von 4 Ebenen bewerten: Inferenz, Retrieval, Kontext und Logs.
Ebene 1: Inferenz
Das ist der Moment, in dem ein Nutzer einen Prompt eingibt, das Modell ihn verarbeitet und die Ausgabe erzeugt wird. Mit anderen Worten: Bei der Inferenz wird aus Ihrer Anfrage tatsächlich eine Antwort. Wenn Sie eine KI-Plattform für den Unternehmenseinsatz bewerten, gehört dieser Punkt zu den ersten, die Sie prüfen sollten. Die Inferenz kann interne Dokumente, Kundendaten, rechtliche Fragen, Strategienotizen oder betriebliche Details umfassen. Ist die Inferenzebene unklar, wird Ihr gesamter KI-Einsatz schwerer zu steuern. Deshalb sollte Inferenz nie auf eine Marketingfloskel wie „in Europa gehostet“ reduziert werden. Sie brauchen eine klare Antwort darauf, wo Anfragen verarbeitet werden, wie Daten während der Generierung fließen und ob Prompt-Daten nach der Erzeugung der Antwort aufbewahrt werden.
Ebene 2: Retrieval-Indizes
Die zweite Ebene sind die Retrieval-Indizes. Wenn die KI auf Ihr Wissen zugreifen kann, müssen Sie wissen, wo dieses Wissen indexiert wird. Viele KI-Tools für Unternehmen erzeugen nicht nur Antworten auf einen Prompt. Sie verbinden sich auch mit Unternehmensdaten wie internen Dokumenten, Wikis, Support-Artikeln, PDFs, Besprechungsnotizen oder Cloud-Laufwerken. Um diese Informationen durchsuchbar zu machen, erstellt die Plattform häufig Indizes. Genau hier verlieren viele Käufer das Gesamtbild aus den Augen. Ein Anbieter mag angeben, dass sein Chat in der EU gehostet wird – speichert die Retrieval-Ebene indexierte Unternehmensdaten jedoch an einem anderen Ort, ist die Frage der Datenresidenz nicht vollständig beantwortet. Sie müssen wissen, wo diese Indizes liegen, wo Embeddings gespeichert werden, wo synchronisierte Inhalte verarbeitet werden und ob verbundene Quellen in der vorgesehenen Region bleiben.
Warum ist das wichtig?
Weil Retrieval-Indizes oft die Struktur Ihres Unternehmenswissens enthalten. Sie sehen vielleicht nicht aus wie das Originaldokument, stellen aber dennoch Unternehmensdaten dar. Wenn Ihr KI-Assistent HR-Richtlinien, Support-Inhalte, juristische Vorlagen oder Produktdokumentation durchsuchen kann, wird die Retrieval-Ebene zu einem zentralen Bestandteil Ihrer Compliance- und Governance-Prüfung.
Ebene 3: Kontextfenster
Die dritte Ebene ist das Kontextfenster. Diese Ebene sorgt bei KI-Systemen für Kontinuität. Sie umfasst die Informationen, die in eine Sitzung übernommen werden, damit das Modell eine relevantere Antwort erzeugen kann. Je nach Plattform können dazu der jüngste Gesprächsverlauf, Workspace-Anweisungen, Gedächtnis, Agenten-Einstellungen, angehängte Dateien und nutzerspezifischer Kontext gehören.
Warum ist das wichtig?
Weil erst der Kontext KI im Unternehmen wirklich nützlich macht. Er hilft dem System zu verstehen, was Ihr Team fragt, auf welche Daten es sich stützen soll und wie es antworten soll. Gleichzeitig kann Kontext aber auch sensible Inhalte enthalten, die sorgfältig verwaltet werden müssen. Sie müssen daher wissen, wie lange Gesprächsverläufe gespeichert werden, ob Administratoren die Aufbewahrung steuern können und ob das Gedächtnis auf Workspace, Nutzer oder Projekt beschränkt ist.
Ebene 4: Reasoning-Logs
Die letzte, aber keineswegs unwichtigste Ebene sind die Reasoning-Logs. Reasoning-Logs sind die Aufzeichnungen darüber, wie eine KI-Anfrage bearbeitet wurde. Je nach Plattform können dazu Nutzungsmetadaten, Tool-Traces, Debugging-Aufzeichnungen, Workflow-Schritte, Zeitstempel, Fehlerprotokolle, Monitoring-Ereignisse und andere Observability-Daten gehören. Diese Ebene wird leicht übersehen, ist aber eine der wichtigsten.
Warum ist das wichtig?
Weil selbst dann, wenn ein Anbieter die Aufbewahrung von Prompts einschränkt, operative Logs weiterhin aussagekräftige Informationen darüber erfassen können, wie das System genutzt wurde. Für Unternehmenskunden betrifft das die Auditierbarkeit, die Reaktion auf Sicherheitsvorfälle, Sicherheitsprüfungen und die interne Governance. Eine Plattform mag an der Oberfläche überzeugen – sind ihre Reasoning-Logs jedoch vage, uneingeschränkt oder schlecht dokumentiert, wird das den Sicherheitsteams auffallen. Deshalb müssen ausgereifte Anbieter von Unternehmens-KI nicht nur klar sagen, wo Antworten erzeugt werden, sondern auch, wie der gesamte Lebenszyklus einer Anfrage überwacht und aufgezeichnet wird.
TextCortex AI: Europäischer Anbieter von Frontier-Modellen und KI-Lösung für Unternehmen
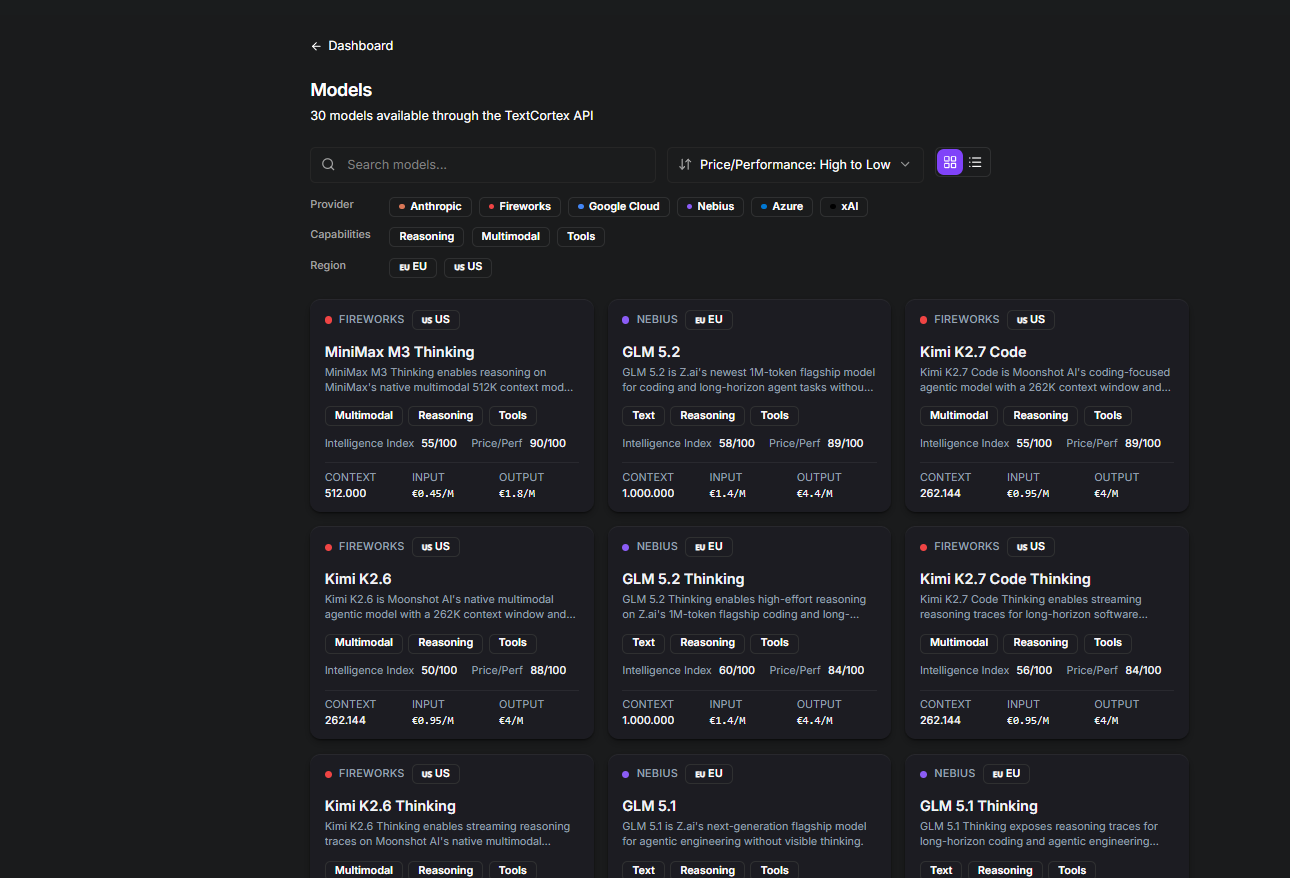
Wenn Sie einen europäischen KI-Anbieter und eine KI-Plattform für Unternehmen suchen, die alle Ebenen der EU-Datenresidenz abdeckt, ist TextCortex die richtige Lösung für Sie. TextCortex ist eine Plattform, die die KI-Anforderungen von Unternehmen erfüllen will, indem sie ihren Nutzern Frontier-KI-Modelle in der EU gehostet und DSGVO-konform bereitstellt. Mit TextCortex können Sie über eine einzige API mehr als 24 Large Language Models nutzen – konform mit der EU-Datenresidenz. Darüber hinaus bietet TextCortex seinen Nutzern Monitoring, Logging und Auditing, sodass Sie Ihre KI-Modelle jederzeit im Blick behalten. Werfen wir einen genaueren Blick auf die Funktionen von TextCortex.
In der EU gehosteter LLM-Zugang
Mit TextCortex können Nutzer über eine einzige API 30 verschiedene Modelle verwenden, die alle in der EU gehostet und DSGVO-konform sind. Dazu gehören Frontier-KI-Modelle wie GPT-5.5, Claude Opus 4.7 und Gemini 3.1 Pro sowie alternative und kostengünstige Optionen wie KimiK2.6, GLM 5.2 und DeepSeek V4 Pro.
In der EU gehostete KI-Plattform für Unternehmen
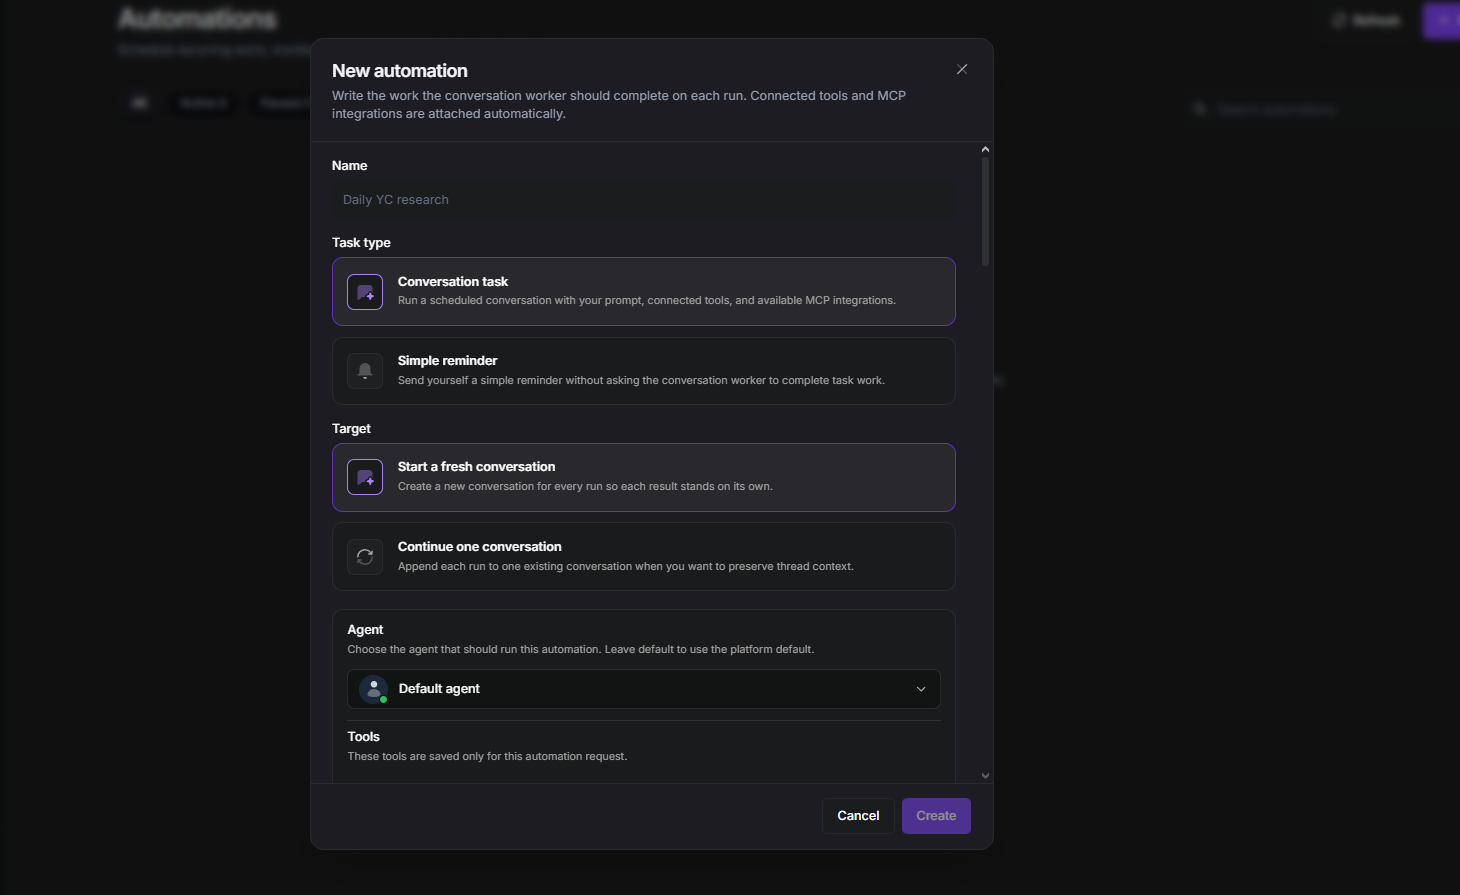
Neben seiner Rolle als LLM-Anbieter bietet TextCortex seinen Nutzern auch eine in der EU gehostete, DSGVO-konforme KI-Plattform für Unternehmen. Mit TextCortex können Sie komplexe und wiederkehrende Workflows automatisieren oder Ihr Wissensmanagement mit einer großen Auswahl an LLMs verbessern. Mit dem KI-Agenten-Framework von TextCortex können Sie Automatisierungsagenten für bestimmte Aufgaben erstellen. Darüber hinaus können Sie mit unseren Wissensdatenbanken Ihre internen Datenbanken in TextCortex integrieren, um im Dialog auf die benötigten Informationen zuzugreifen oder Ihre Rohdaten in nützliche Ergebnisse zu verwandeln.
Häufig gestellte Fragen
Was ist EU-Datenresidenz für KI?
Sie beschreibt, wo KI-bezogene Daten im gesamten KI-Stack verarbeitet, gespeichert, indexiert oder protokolliert werden.
Ist Hosting in der EU dasselbe wie KI-Souveränität?
Nein. Beim Hosting in der EU geht es um den Standort. Souveränität umfasst zusätzlich Rechtsordnung, Governance, Kontrolle und operative Unabhängigkeit.
Was sollten Unternehmen über den Ort der Inferenz hinaus prüfen?
Sie sollten auch Retrieval, Kontext und Logs überprüfen.
Kann ein KI-Tool DSGVO-konform sein, wenn es Modellanbieter aus den USA nutzt?
Das hängt von Architektur, Verträgen, Schutzmaßnahmen, Datenflüssen und Governance-Kontrollen ab. Käufer sollten die gesamte Verarbeitungskette überprüfen.