EU-datalagring (data residency) avser den fysiska eller geografiska plats där en organisations digitala data lagras och behandlas, närmare bestämt inom Europeiska unionens (EU) eller Europeiska ekonomiska samarbetsområdets (EES) gränser. För företag och organisationer är EU-datalagring viktigt ur ett perspektiv av regelefterlevnad, datasuveränitet och användarnas förtroende. Undrar du vad EU-datalagring innebär för ett företags AI-stack och vill du veta vilka punkter du behöver kontrollera innan du väljer en AI-plattform? Då har du kommit rätt!
I den här artikeln förklarar vi vad EU-datalagring är och vad det faktiskt betyder för företags AI-stackar.
TL;DR
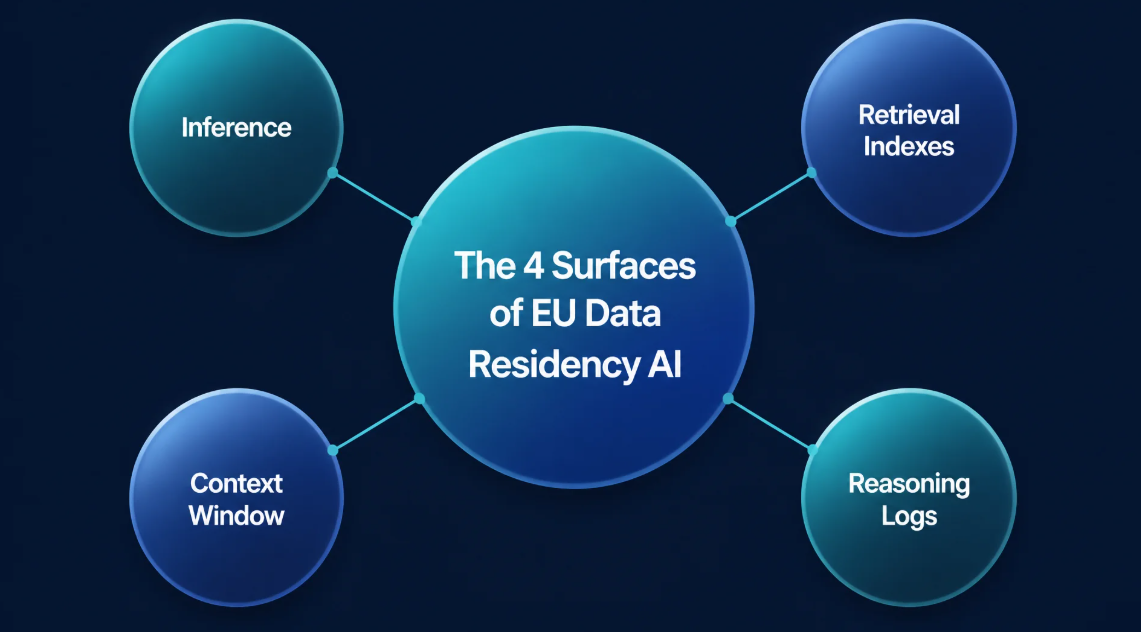
EU-datalagring innebär att all AI-data i ett företag lagras och behandlas inom EU:s eller EES gränser. Det handlar inte bara om var modellen körs, utan också om var prompter, hämtat innehåll, kontext och loggar finns. Begreppet skiljer sig från närliggande koncept: datalagring handlar om plats, suveränitet om rättslig jurisdiktion och regelefterlevnad om att uppfylla styrningskrav. För att korrekt bedöma en AI-plattforms påståenden om datalagring bör du kontrollera fyra ytor: inferens (var prompter behandlas och svar genereras), sökindex (var företagets kunskap indexeras och embeddings lagras), kontextfönster (hur konversationshistorik, minne och bifogade filer sparas och hanteras) och resonemangsloggar (operativa metadata, verktygsspår och observerbarhetsdata). En leverantör som påstår sig vara "hostad i Europa" utan att vara tydlig med alla fyra lagren lämnar luckor i regelefterlevnaden. TextCortex täcker alla fyra ytor och erbjuder över 24 EU-hostade, GDPR-kompatibla LLM:er (bland annat GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro och prisvärda alternativ som Kimi K2.6, GLM 5.2 och DeepSeek V4 Pro) via ett enda API, med inbyggd övervakning, loggning och granskning, AI-agenter och kunskapsbaser för företag.
Vad EU-datalagring innebär för AI
AI-datalagring inom EU är det snabbaste sättet för organisationer och företag att använda generativ AI, AI-agenter och AI-modeller utan att kompromissa med dataskyddet. EU-datalagring för AI handlar inte bara om att lagra AI-modellens data på EU-hostade servrar; det kräver också att all in- och utdata från modellen behandlas inom EU:s eller EES gränser.
Varför är EU-datalagring viktigt?
Kärnan i EU-datalagring är att säkerställa att dataflödet stannar inom EU:s gränser i varje steg av företagets eller organisationens arbetsflöde, så att dataläckor förhindras. EU-datalagring skyddar känslig information om organisationen eller verksamheten, inklusive prompter, hämtat innehåll, loggar, svar och annan data som används eller genereras av AI. Som användare kan du därmed tydligt spåra och kartlägga var din organisations data behandlas, lagras och loggas.
Skillnaden mellan datalagring, suveränitet och regelefterlevnad
Vid första anblick kan datalagring, suveränitet och regelefterlevnad verka betyda samma sak, men de är olika delar av liknande frågor. Skillnaden mellan de tre begreppen kan kort sammanfattas så här:
- Datalagring: Var data lagras eller behandlas.
- Datasuveränitet: Vilken rättslig jurisdiktion som kan påverka den datan.
- Regelefterlevnad: Om helheten uppfyller rättsliga krav och styrningskrav.
Även om EU-hosting är viktigt för AI-plattformar är det bara en del av helhetsbilden.
De 4 ytorna för EU-datalagring inom AI
AI-datalagring handlar inte bara om var appen hostas. Det omfattar också var prompter behandlas, var företagsdata indexeras, hur mycket kontext som sparas och vad som skrivs till loggar. Därför är det mest tillförlitliga sättet att bedöma AI-datalagring att utgå från 4 ytor: inferens, sökning, kontext och loggar.
Lager 1: Inferens
Det här är ögonblicket när en användare skriver in en prompt, modellen behandlar den och svaret genereras. Med andra ord är det vid inferensen som din förfrågan faktiskt blir ett svar. Om du utvärderar en AI-plattform för företagsbruk är detta en av de första sakerna du behöver kontrollera. Inferensen kan omfatta interna dokument, kunddata, juridiska frågor, strategianteckningar eller operativa detaljer. Om inferenslagret är otydligt blir hela din AI-implementering svårare att styra. Därför bör inferens aldrig reduceras till en marknadsföringsfras som "hostad i Europa". Du behöver ett tydligt svar på var förfrågningar behandlas, hur data flödar under genereringen och om promptdata sparas efter att svaret har tagits fram.
Lager 2: Sökindex
Den andra ytan är sökindexen. Om AI:n har tillgång till din kunskap behöver du veta var den kunskapen indexeras. Många AI-verktyg för företag gör mer än att generera svar utifrån en prompt. De ansluter också till företagsdata som interna dokument, wikis, supportartiklar, PDF-filer, mötesanteckningar eller molnlagring. För att göra informationen sökbar skapar plattformen ofta index. Det är här många köpare missar helhetsbilden. En leverantör kan säga att dess chatt är EU-hostad, men om söklagret lagrar indexerad företagsdata någon annanstans är frågan om datalagring inte helt besvarad. Du behöver veta var indexen finns, var embeddings lagras, var synkroniserat innehåll behandlas och om anslutna källor stannar inom den avsedda regionen.
Varför är detta viktigt?
Eftersom sökindex ofta innehåller strukturen i företagets kunskap. De kanske inte ser ut som originaldokumentet, men de utgör ändå företagsdata. Om din AI-assistent kan söka i HR-policyer, kundsupportinnehåll, juridiska mallar eller produktdokumentation blir söklagret en central del av din granskning av regelefterlevnad och styrning.
Lager 3: Kontextfönster
Den tredje ytan är kontextfönstret. Det är det lager som ger AI-system kontinuitet. Det omfattar den information som förs med in i en session så att modellen kan generera ett mer relevant svar. Beroende på plattform kan det inkludera nylig konversationshistorik, instruktioner för arbetsytan, minne, agentinställningar, bifogade filer och användarspecifik kontext.
Varför är detta viktigt?
Eftersom det är kontexten som gör AI för företag verkligt användbar. Den hjälper systemet att förstå vad ditt team frågar om, vilken data det ska utgå från och hur det ska svara. Samtidigt kan kontexten också innehålla känsligt material som måste hanteras varsamt. Därför behöver du veta hur länge konversationshistorik lagras, om administratörer kan styra lagringstiden och om minnet är begränsat per arbetsyta, användare eller projekt.
Lager 4: Resonemangsloggar
Den sista men inte minst viktiga ytan är resonemangsloggarna. Resonemangsloggar är de uppgifter som skapas om hur en AI-förfrågan har hanterats. Beroende på plattform kan det omfatta användningsmetadata, verktygsspår, felsökningsdata, arbetsflödessteg, tidsstämplar, felloggar, övervakningshändelser och annan observerbarhetsdata. Den här ytan är lätt att förbise, men den är en av de viktigaste.
Varför är detta viktigt?
Eftersom operativa loggar, även när en leverantör begränsar lagringen av prompter, fortfarande kan fånga betydelsefull information om hur systemet har använts. För företagskunder påverkar detta spårbarhet, incidenthantering, säkerhetsgranskning och intern styrning. En plattform kan se stark ut i gränssnittet, men om dess resonemangsloggar är vaga, obegränsade eller dåligt dokumenterade kommer säkerhetsteamen att märka det. Därför måste mogna leverantörer av AI för företag vara tydliga inte bara med var svaren genereras, utan också med hur hela förfrågans livscykel övervakas och registreras.
TextCortex AI: Europeisk leverantör av frontier-modeller och AI-lösning för företag
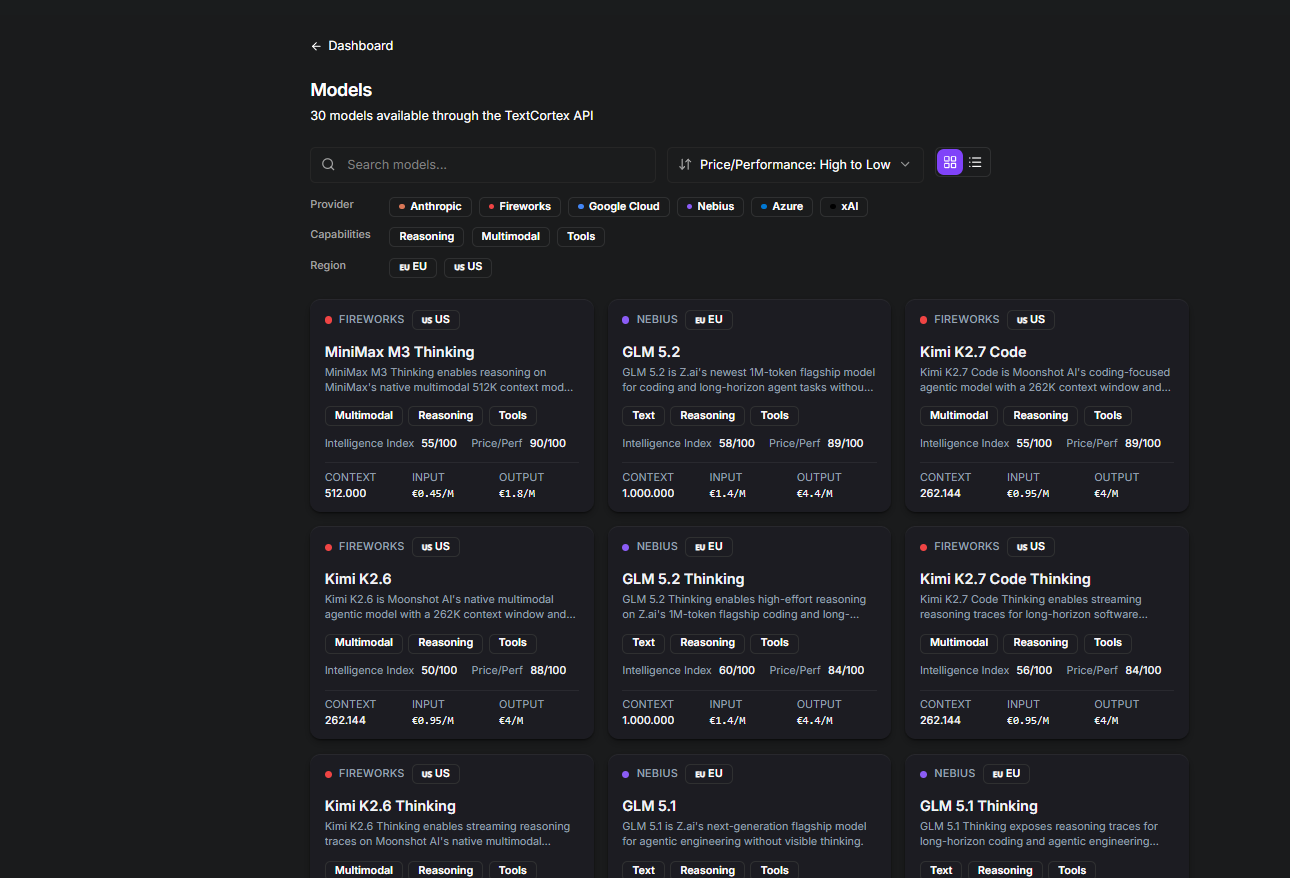
Om du letar efter en europeisk AI-leverantör och en plattform med AI-verktyg för företag som erbjuder alla nivåer av EU-datalagring är TextCortex lösningen för dig. TextCortex är en plattform som vill möta företagens AI-behov genom att erbjuda användarna frontier-AI-modeller som är EU-hostade och GDPR-kompatibla. Med TextCortex kan du använda över 24 stora språkmodeller via ett enda API, i enlighet med EU-datalagring. Dessutom erbjuder TextCortex övervakning, loggning och granskning, så att du alltid har koll på dina AI-modeller. Låt oss titta närmare på TextCortex funktioner.
EU-hostad åtkomst till LLM:er
Med TextCortex kan användare använda 30 olika modeller via ett enda API, alla EU-hostade och GDPR-kompatibla. Bland dem finns frontier-AI-modeller som GPT-5.5, Claude Opus 4.7 och Gemini 3.1 Pro, samt alternativa och prisvärda alternativ som KimiK2.6, GLM 5.2 och DeepSeek V4 Pro.
EU-hostad AI-upplevelse för företag
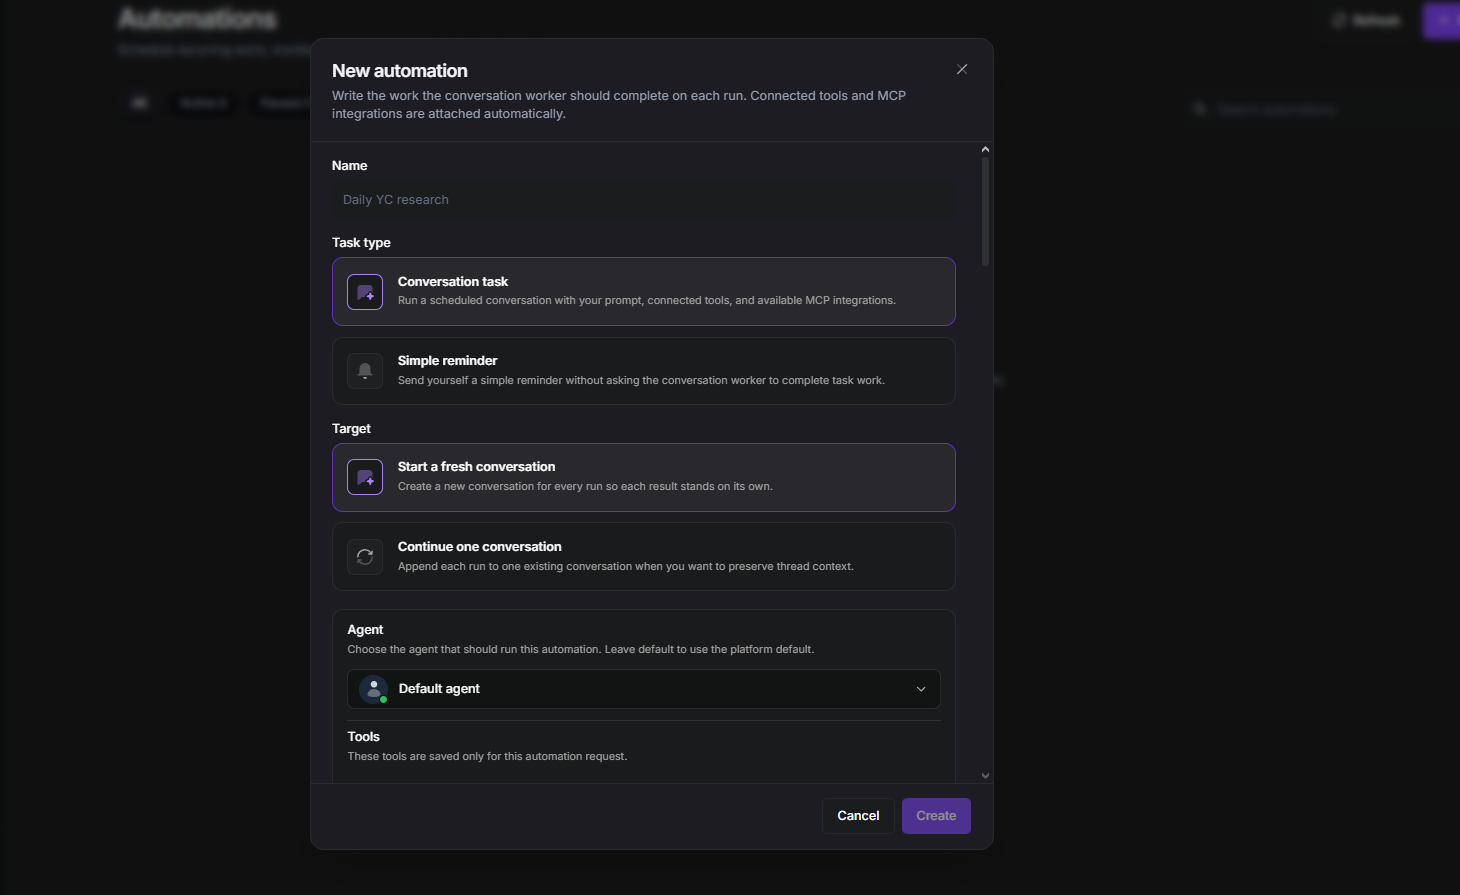
Förutom att vara en LLM-leverantör erbjuder TextCortex även användarna en EU-hostad, GDPR-kompatibel AI-plattform för företag. Med TextCortex kan du automatisera komplexa och repetitiva arbetsflöden eller förbättra din kunskapshantering med ett brett urval av LLM:er. Du kan bygga automatiseringsagenter för specifika uppgifter med TextCortex ramverk för AI-agenter. Med våra kunskapsbaser kan du dessutom integrera dina interna databaser med TextCortex för att få tillgång till den information du behöver i samtalsform eller omvandla din rådata till användbara resultat.
Vanliga frågor och svar
Vad är EU-datalagring för AI?
Det avser var AI-relaterad data behandlas, lagras, indexeras eller loggas i hela AI-stacken.
Är EU-hosting detsamma som AI-suveränitet?
Nej. EU-hosting handlar om plats. Suveränitet omfattar även jurisdiktion, styrning, kontroll och operativt oberoende.
Vad bör företag kontrollera utöver var inferensen sker?
De bör också kontrollera sökning, kontext och loggar.
Kan ett AI-verktyg vara förenligt med GDPR om det använder amerikanska modelleverantörer?
Det beror på arkitektur, avtal, skyddsåtgärder, dataflöden och styrningskontroller. Köpare bör kontrollera hela behandlingskedjan.