Efter Anthropic och OpenAI har nu även Google lanserat en modell som levererar hög prestanda med lägre tokenförbrukning inom kodning, kunskapsarbete och agentiska resonemangsuppgifter: Gemini 3.6 Flash. Gemini 3.6 Flash är tillgänglig både via API och via Gemini AI, och lanseras tillsammans med modellerna 3.5 Flash Lite och 3.5 Flash Cyber. Är du nyfiken på vad Gemini 3.6 Flash är och vad den kan? Här får du veta allt!
I den här artikeln går vi igenom funktionerna och prestandan hos Gemini 3.6 Flash.
TL;DR
Google släppte Gemini 3.6 Flash den 21 juli 2026: en lätt modell med låg latens, optimerad för kodning, agentiskt resonemang, multimodala uppgifter och kunskapsarbete, med ett starkt pris-prestanda-förhållande. Den finns tillgänglig tillsammans med Gemini 3.5 Flash Lite och Gemini 3.5 Flash Cyber. Du kan prova den gratis via Gemini AI, och API-åtkomst kostar $1.5 per miljon input-tokens och $7.5 per miljon output-tokens. Gemini 3.6 Flash använder 17 % färre tokens än Gemini 3.5 Flash, vilket sänker de totala kostnaderna samtidigt som prestandan förbättras. Den har också inbyggd datoranvändning för pålitliga agentiska arbetsflöden och överträffar frontiermodeller inom verktygsanvändning och kunskapsarbete, även om den fortfarande ligger 18 % efter GPT-5.6 Luna på DeepSWE v1.1. Som standard uppfyller modellen inte EU:s AI-förordning eller GDPR, men TextCortex erbjuder den som ett EU-hostat, regelefterlevande API och som motor för anpassade AI-agenter, kunskapsbaser och automatisering av arbetsflöden.
Vad är Gemini 3.6 Flash?
Gemini 3.6 Flash är en stor språkmodell som utvecklats av Google och släpptes den 21 juli 2026. Jämfört med sina föregångare erbjuder den avancerad kodning, agentiskt resonemang, hög prestanda i multimodala uppgifter, låg latens och pålitlig prestanda. Gemini 3.6 Flash har som mål att erbjuda det optimala pris-prestanda-förhållandet för agentiska arbetsflöden. Den har utvecklats utifrån kundfeedback och utvecklares kommentarer om tidigare Gemini-modeller.
Är Gemini 3.6 Flash gratis att använda?
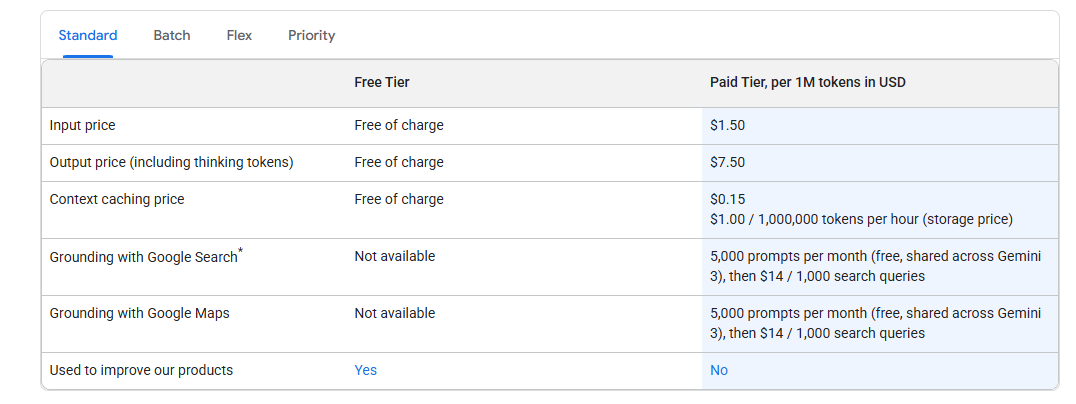
Du kan använda och prova modellen Gemini 3.6 Flash gratis via Gemini AI. Men om du vill använda Gemini 3.6 Flash som API i ditt företags arbetsflöde behöver du betala enligt API-prissättningen. API-priserna för modellen Gemini 3.6 Flash är följande:
- $1.5 per miljon input-tokens
- $7.5 per miljon output-tokens
Hur får du tillgång till Gemini 3.6 Flash?
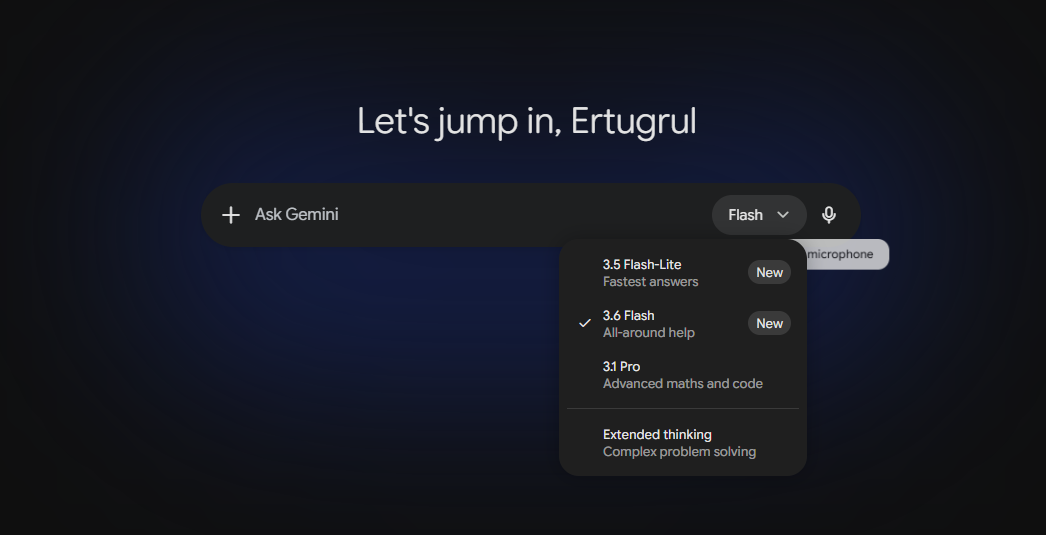
Det enklaste och mest direkta sättet att använda modellen Gemini 3.6 Flash är via chattboten Gemini AI. Där kan du använda modellen Gemini 3.6 Flash helt kostnadsfritt.
Ett annat sätt att få tillgång till modellen Gemini Flash 3.6 är att använda den som API. Men om du letar efter ett innovativt och företagsinriktat sätt att använda Gemini Flash 3.6 kan du använda TextCortex. Med TextCortex kan du integrera ett brett utbud av stora språkmodeller, däribland Gemini Flash 3.6, i ditt företags arbetsflöde.
Gemini 3.6 Flash: funktioner & prestanda
Modellen Gemini 3.6 Flash kommer med nya funktioner, förmågor och prestandagränser, där den mest framträdande är lägre tokenförbrukning. Är du nyfiken på vad Gemini 3.6 Flash har att erbjuda? Vi har listat funktionerna åt dig!
Benchmarkprestanda
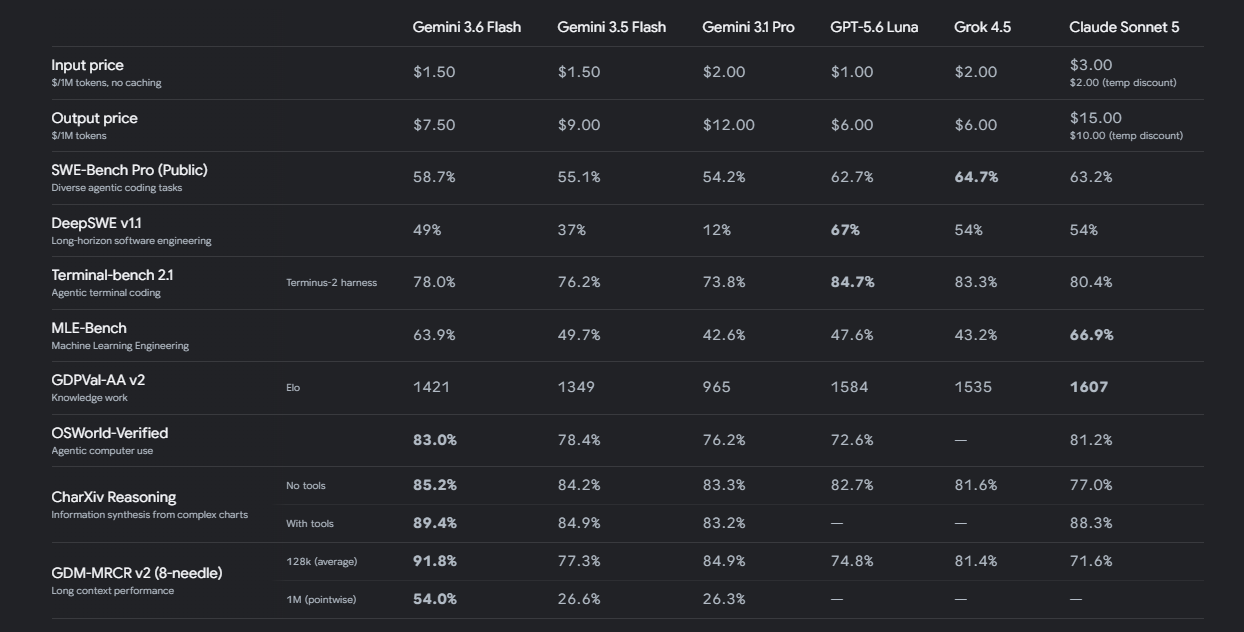
Även om modellen Gemini 3.6 Flash har betydligt bättre benchmarkprestanda än sina föregångare överträffar den inte konkurrenterna i alla benchmarks. Till exempel får Gemini 3.6 Flash högre poäng än både sina föregångare och konkurrenter i benchmarken OSWorld-Verified, men ligger 18 % efter modellen GPT-5.6 Luna i benchmarken DeepSWE v1.1.
Lägre tokenförbrukning
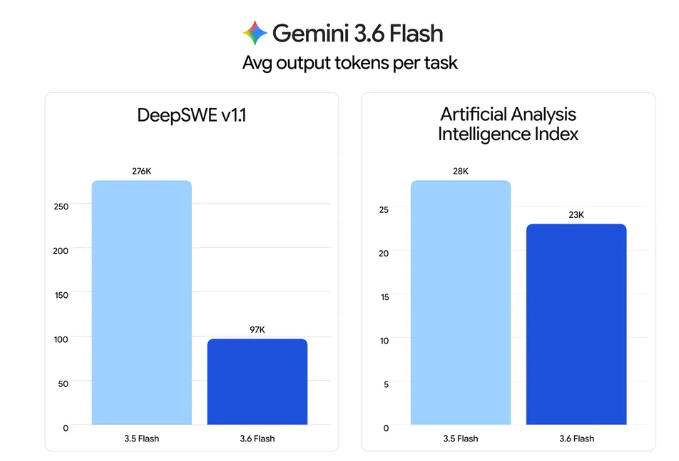
Modellen Gemini 3.6 Flash använder 17 % färre tokens för att utföra samma uppgifter som sin föregångare, modellen Gemini Flash 3.5. Enligt Googles artikel förbrukade Gemini 3.6 Flash 17 % färre tokens än Gemini 3.5 Flash i Artificial Analysis Index. Det innebär att du med Gemini 3.6 Flash kan spara kostnader genom att förbruka färre tokens i dina automatiserade arbetsflöden. Dessutom ökar de lägre priserna för input och output jämfört med föregångaren dina besparingar avsevärt. Tack vare den högre prestandan klarar modellen också mer komplexa uppgifter enklare.
Bättre agentisk prestanda
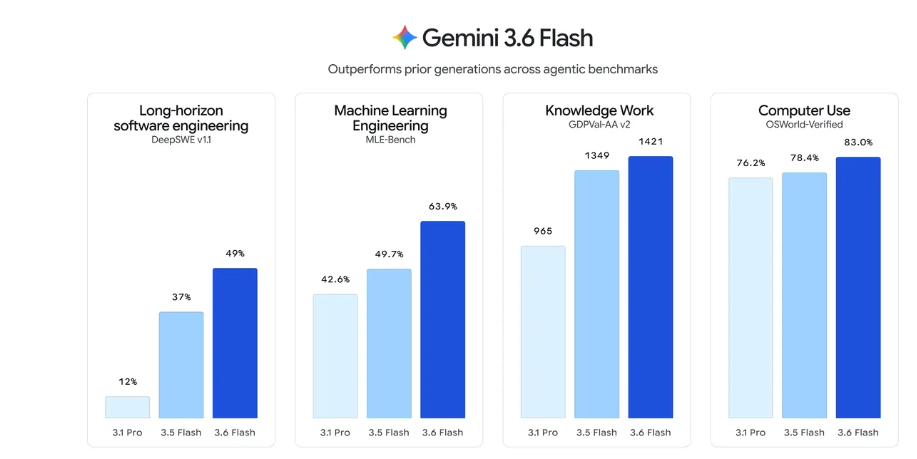
Modellen Gemini 3.6 Flash ger betydligt bättre prestanda inom agentiskt resonemang, kunskapsarbete, verktygsanvändning och maskininlärningsteknik jämfört med sina föregångare, modellerna Gemini 3.5 Flash och Gemini Pro 3.1. Den agentiska prestandan gör Gemini 3.6 Flash idealisk för att automatisera repetitiva, komplexa arbetsflöden i flera steg. Dessutom överträffar Gemini 3.6 Flash frontiermodeller i agentiska uppgifter som involverar verktygsanvändning och kunskapsarbete. Modellen har också datoranvändning som inbyggt verktyg för att på ett pålitligt sätt stödja agentiska uppgifter i olika miljöer.
TextCortex AI: använd Gemini 3.6 Flash i ditt företag
Om du vill använda modellen Gemini 3.6 Flash för att automatisera ditt företags arbetsflöde och förbättra ditt kunskapsarbete är TextCortex AI lösningen du letar efter. TextCortex är en ledande plattform för kunskapshantering och automatisering av arbetsflöden som syftar till att minska företagens arbetsbörda och spara tid och kostnader. Med TextCortex kan du använda ett brett utbud av kraftfulla frontier-språkmodeller, däribland Gemini 3.6 Flash, för att automatisera eller snabba upp ditt företags uppgifter.
Använd Gemini 3.6 Flash hostad i EU
Som standard uppfyller modellen Gemini 3.6 Flash inte EU:s AI-förordning och GDPR. Om du vill använda Gemini 3.6 Flash i enlighet med GDPR är TextCortex lösningen för dig. Med TextCortex API kan du använda Gemini 3.6 Flash EU-hostad och GDPR-kompatibel. TextCortex erbjuder frontier-LLM:er, däribland Gemini 3.6 Flash, och andra kostnadseffektiva LLM:er som EU-hostade och GDPR-kompatibla. Det gör att du kan använda Gemini 3.6 Flash i dina verksamheter i Europa utan juridiska problem.
AI-agenter som drivs av Gemini 3.6 Flash
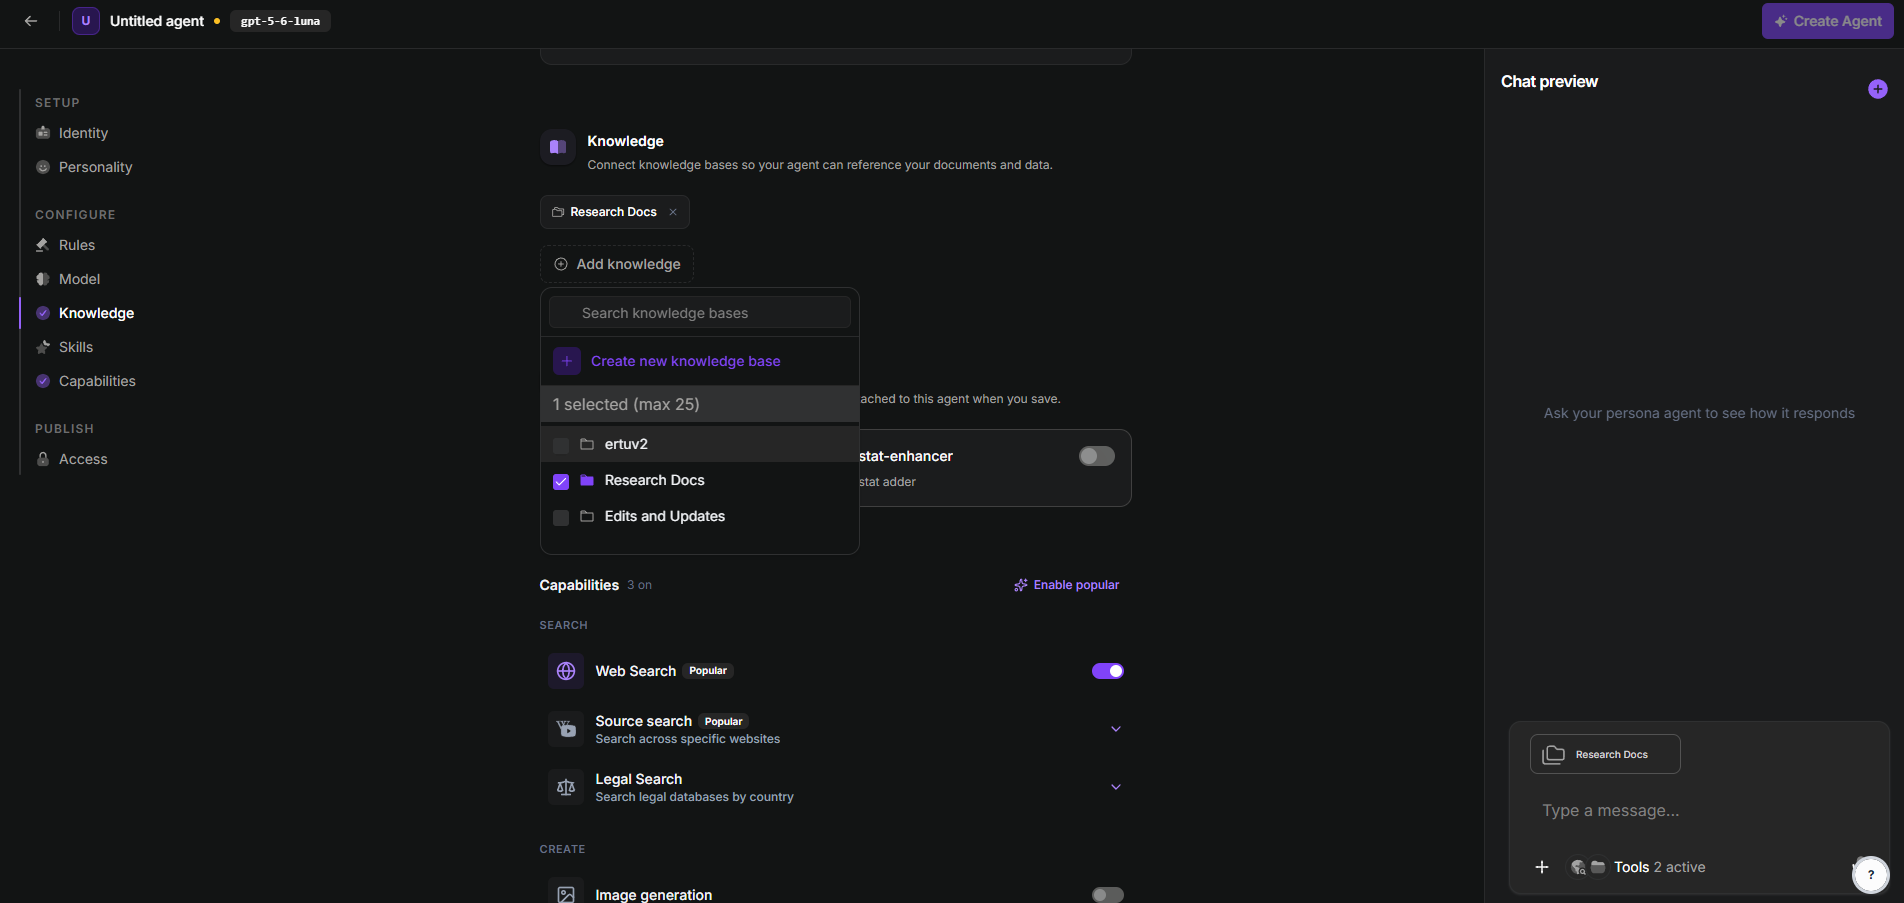
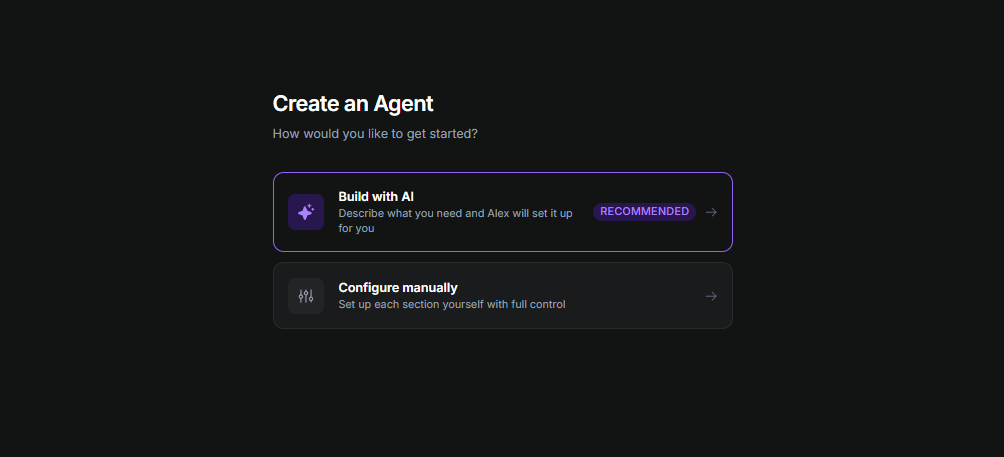
Ett effektivt sätt att använda modellen Gemini 3.6 Flash är att automatisera dina arbetsflöden eller effektivisera dina uppgifter genom att använda den som AI-agent. Med TextCortex kan du bygga anpassade AI-agenter för vilken uppgift eller vilket arbetsflöde som helst, och till och med finjustera dem med modulära beteenderegler som kallas "skills". Det finns två sätt att bygga en AI-agent med TextCortex. Det första är att bygga den AI-agent du behöver i konversationsform med stöd av AI. Det andra är ett manuellt byggramverk där du kan anpassa allt, från standardmodellen till de beteenden som agenten alltid eller aldrig ska utföra.
Stärk dina AI-agenter med kunskapsbaser
TextCortex erbjuder sina användare kunskapsbaser där de kan koppla sina interna databaser eller ladda upp dokument manuellt. Med våra kunskapsbaser kan du integrera de databaser du använder i ditt företags uppgifter i TextCortex. Sedan kan du använda databaserna för kunskapsarbete eller AI-sökning via AI-chattbotar. Om du vill att dina TextCortex-AI-agenter ska arbeta med specifika databaser kan du dessutom tilldela dem dina kunskapsbaser när du bygger dem. Ett annat sätt att använda AI-agenter och databaser tillsammans är att skriva kunskapsbasens namn med symbolen "@" i chattrutan under användningen, till exempel "@Research Docs". Därefter kan du använda dina AI-agenter för att utföra uppgifter som dataanalys, AI-sökning och att omvandla rådata till insikter med den kunskapsbas du vill.