EUデータレジデンシーとは、組織のデジタルデータが保存・処理される物理的または地理的な場所、具体的には欧州連合(EU)または欧州経済領域(EEA)の域内を指します。EUデータレジデンシーは、規制へのコンプライアンス、データ主権、そしてユーザーからの信頼という点で、企業や組織にとって重要です。EUデータレジデンシーが企業のAIスタックにとって何を意味するのか、またAIプラットフォームを選ぶ前に確認すべきチェック項目を知りたい方は、ぜひこの記事をお読みください。
この記事では、EUデータレジデンシーとは何か、そして企業のAIスタックにとって実際にどのような意味を持つのかを解説します。
TL;DR
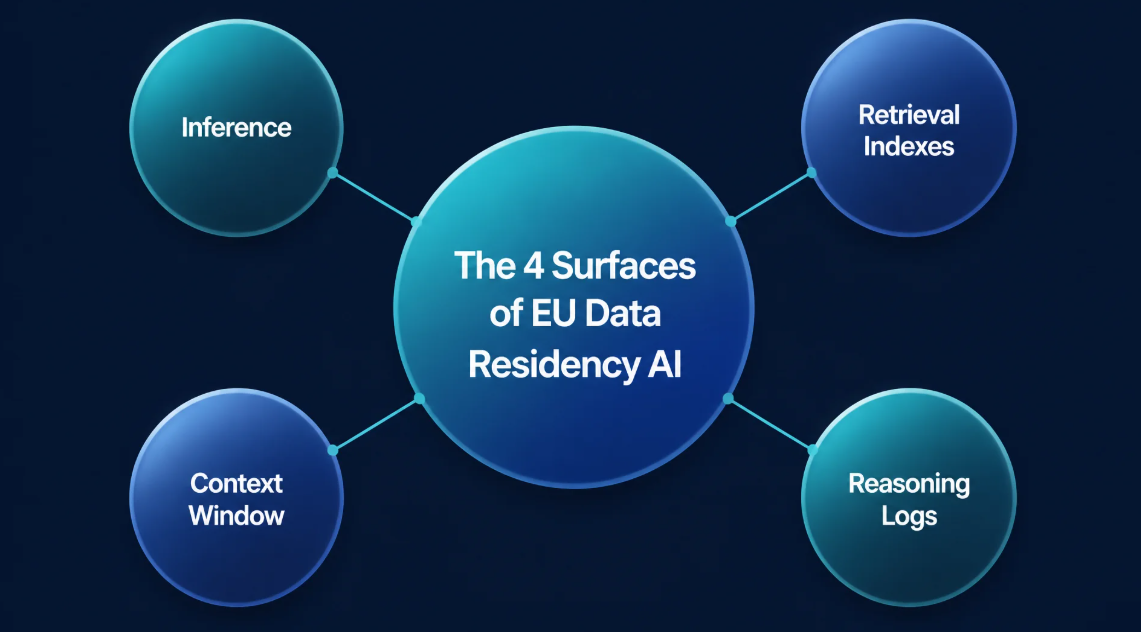
EUデータレジデンシーとは、企業のAIデータをすべてEUまたはEEAの域内で保存・処理することを意味します。対象はモデルが稼働する場所だけでなく、プロンプト、検索で取得されたコンテンツ、コンテキスト、ログが置かれる場所にも及びます。これは関連する概念とは異なります。レジデンシーは場所、主権は法的な管轄、コンプライアンスはガバナンス要件を満たしているかどうかに関わるものです。AIプラットフォームのレジデンシーに関する主張を正しく評価するには、4つのサーフェスを確認しましょう。推論(プロンプトが処理され、出力が生成される場所)、検索インデックス(社内ナレッジがインデックス化され、埋め込みが保存される場所)、コンテキストウィンドウ(会話履歴、メモリ、添付ファイルの保持と管理の方法)、そして推論ログ(運用メタデータ、ツールのトレース、オブザーバビリティの記録)です。4つのレイヤーすべてについて明確にしないまま「欧州でホスト」とうたうベンダーでは、コンプライアンス上の抜け穴が残ります。TextCortexは4つのサーフェスすべてに対応し、EUでホストされGDPRに準拠した24以上のLLM(GPT-5.5、Claude Opus 4.7、Gemini 3.1 Pro、さらにKimi K2.6、GLM 5.2、DeepSeek V4 Proなどの低コストな選択肢を含む)を単一のAPIで提供しています。モニタリング、ロギング、監査機能、AIエージェント、企業向けナレッジベースも標準で備えています。
AIにとってのEUデータレジデンシーの意味
EUでのAIデータレジデンシーは、組織や企業がデータ保護を損なうことなく、生成AI、AIエージェント、AIモデルを活用するための最も早い方法です。AIにおけるEUデータレジデンシーは、AIモデルのデータをEUでホストされたサーバーに保存するだけにとどまりません。モデルへの入力データと出力データのすべてを、EUまたはEEAの域内で処理することも求められます。
EUデータレジデンシーはなぜ重要なのか?
EUデータレジデンシーの要点は、企業や組織のワークフローのあらゆる段階でデータの流れをEU域内にとどめ、データ漏えいを防ぐことにあります。EUデータレジデンシーにより、プロンプト、取得されたコンテンツ、ログ、出力など、AIが使用・生成するデータを含む、組織や事業の機密情報が守られます。これにより、ユーザーであるあなたは、組織のデータがどこで処理・保存・記録されているかを明確に追跡し、把握できます。
データレジデンシー、データ主権、コンプライアンスの違い
一見すると、データレジデンシー、データ主権、コンプライアンスは同じことを指しているように思えるかもしれませんが、実際には似たような課題の異なる側面です。この3つの概念の違いは、次のように簡単にまとめられます。
- データレジデンシー:データがどこで保存・処理されるか。
- データ主権:そのデータにどの法的管轄が影響し得るか。
- コンプライアンス:全体の構成が法的要件とガバナンス要件を満たしているかどうか。
AIプラットフォームにとってEUでのホスティングは重要ですが、それは全体像の一部にすぎません。
EUデータレジデンシーAIの4つのサーフェス
AIのデータレジデンシーは、アプリがどこでホストされているかだけの問題ではありません。プロンプトがどこで処理されるか、企業データがどこでインデックス化されるか、どれだけのコンテキストが保持されるか、そしてログに何が書き込まれるかも含まれます。だからこそ、AIのレジデンシーを評価する最も確実な方法は、推論、検索、コンテキスト、ログという4つのサーフェスで見ることなのです。
レイヤー1:推論
推論とは、ユーザーがプロンプトを入力し、モデルがそれを処理して出力を生成する瞬間のことです。言い換えれば、推論はリクエストが実際に回答へと変わる場所です。企業での利用に向けてAIプラットフォームを評価する際、これは最初に確認すべき項目の一つです。推論では、社内文書、顧客データ、法務上の質問、戦略メモ、業務の詳細などが扱われることがあります。推論レイヤーが不明確だと、AI導入全体のガバナンスが難しくなります。そのため、推論を「欧州でホスト」といったマーケティング上の言葉だけで片付けてはいけません。リクエストがどこで処理されるのか、生成中にデータがどのように流れるのか、そして回答の生成後にプロンプトのデータが保持されるのかについて、明確な答えが必要です。
レイヤー2:検索インデックス
2つ目のサーフェスは検索インデックスです。AIが社内のナレッジにアクセスできるなら、そのナレッジがどこでインデックス化されているかを把握する必要があります。多くの企業向けAIツールは、プロンプトから回答を生成するだけではありません。社内文書、Wiki、サポート記事、PDF、議事録、クラウドドライブなどの企業データにも接続します。こうした情報を検索可能にするため、プラットフォームはしばしばインデックスを作成します。多くの購入担当者が全体像を見落としがちなのが、まさにこの部分です。ベンダーがチャット機能はEUでホストされていると説明していても、検索レイヤーがインデックス化された企業データを別の場所に保存しているなら、レジデンシーの問題は完全には解決していません。インデックスがどこにあるのか、埋め込みがどこに保存されるのか、同期されたコンテンツがどこで処理されるのか、そして接続されたソースが想定したリージョン内にとどまるのかを確認する必要があります。
なぜ重要なのか?
検索インデックスには、多くの場合、社内ナレッジの構造が含まれているからです。元の文書とは見た目が異なるかもしれませんが、それでも企業データであることに変わりはありません。AIアシスタントが人事規程、カスタマーサポートのコンテンツ、法務テンプレート、製品ドキュメントを検索できるのであれば、検索レイヤーはコンプライアンスとガバナンスのレビューにおいて重要な要素になります。
レイヤー3:コンテキストウィンドウ
3つ目のサーフェスはコンテキストウィンドウです。これは、AIシステムに継続性をもたらすレイヤーです。モデルがより適切な回答を生成できるよう、セッションに引き継がれる情報が含まれます。プラットフォームによっては、最近の会話履歴、ワークスペースの指示、メモリ、エージェントの設定、添付ファイル、ユーザー固有のコンテキストなどが含まれます。
なぜ重要なのか?
コンテキストこそが、企業向けAIを本当に役立つものにしているからです。コンテキストは、チームが何を尋ねているのか、どのデータに基づくべきか、どのように回答すべきかをシステムが理解する助けになります。しかし同時に、コンテキストには慎重に管理すべき機密情報が含まれることもあります。そのため、会話履歴がどのくらいの期間保存されるのか、管理者が保持期間を制御できるのか、メモリがワークスペース、ユーザー、プロジェクト単位で制限されているのかを把握しておく必要があります。
レイヤー4:推論ログ
最後になりましたが、決して軽視できないサーフェスが推論ログです。推論ログとは、AIへのリクエストがどのように処理されたかについて作成される記録を指します。プラットフォームによっては、利用状況のメタデータ、ツールのトレース、デバッグ記録、ワークフローのステップ、タイムスタンプ、エラーログ、モニタリングイベント、その他のオブザーバビリティデータが含まれます。このサーフェスは見落とされがちですが、最も重要なものの一つです。
なぜ重要なのか?
ベンダーがプロンプトの保持を制限していても、運用ログにはシステムがどのように使われたかについての重要な情報が記録される可能性があるからです。企業の購入担当者にとって、これは監査可能性、インシデント対応、セキュリティレビュー、社内ガバナンスに影響します。インターフェース上は堅牢に見えるプラットフォームでも、推論ログが曖昧だったり、制限がなかったり、十分に文書化されていなかったりすれば、セキュリティチームはそれに気づきます。だからこそ、成熟した企業向けAIベンダーには、回答がどこで生成されるかだけでなく、リクエストのライフサイクル全体がどのように監視・記録されるかについても明確にすることが求められます。
TextCortex AI:欧州のフロンティアモデルプロバイダーであり企業向けAIソリューション
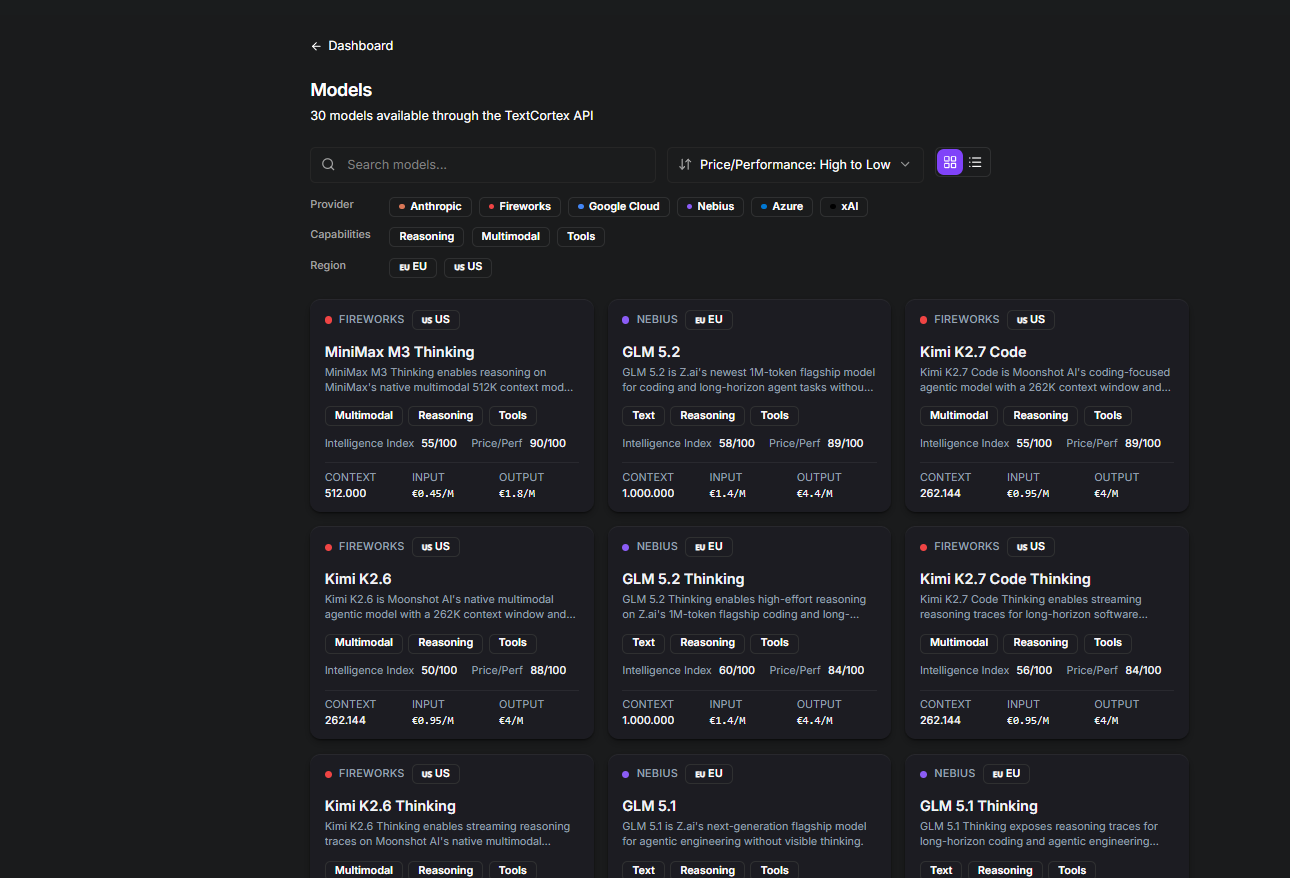
EUデータレジデンシーのすべての階層に対応した欧州のAIプロバイダーであり、企業向けAIツールのプラットフォームをお探しなら、TextCortexが最適です。TextCortexは、EUでホストされGDPRに準拠した形でフロンティアAIモデルをユーザーに提供することで、企業のAIニーズに応えることを目指すプラットフォームです。TextCortexなら、EUデータレジデンシーに準拠しながら、単一のAPIで24以上の大規模言語モデルを利用できます。さらに、TextCortexはモニタリング、ロギング、監査の機能を提供しているため、AIモデルの状況を常に把握できます。それでは、TextCortexの機能を詳しく見ていきましょう。
EUでホストされたLLMへのアクセス
TextCortexでは、EUでホストされGDPRに準拠した30種類のモデルを単一のAPIで利用できます。これには、GPT-5.5、Claude Opus 4.7、Gemini 3.1 ProといったフロンティアAIモデルに加え、KimiK2.6、GLM 5.2、DeepSeek V4 Proなどの代替となる低コストな選択肢も含まれます。
EUでホストされた企業向けAI体験
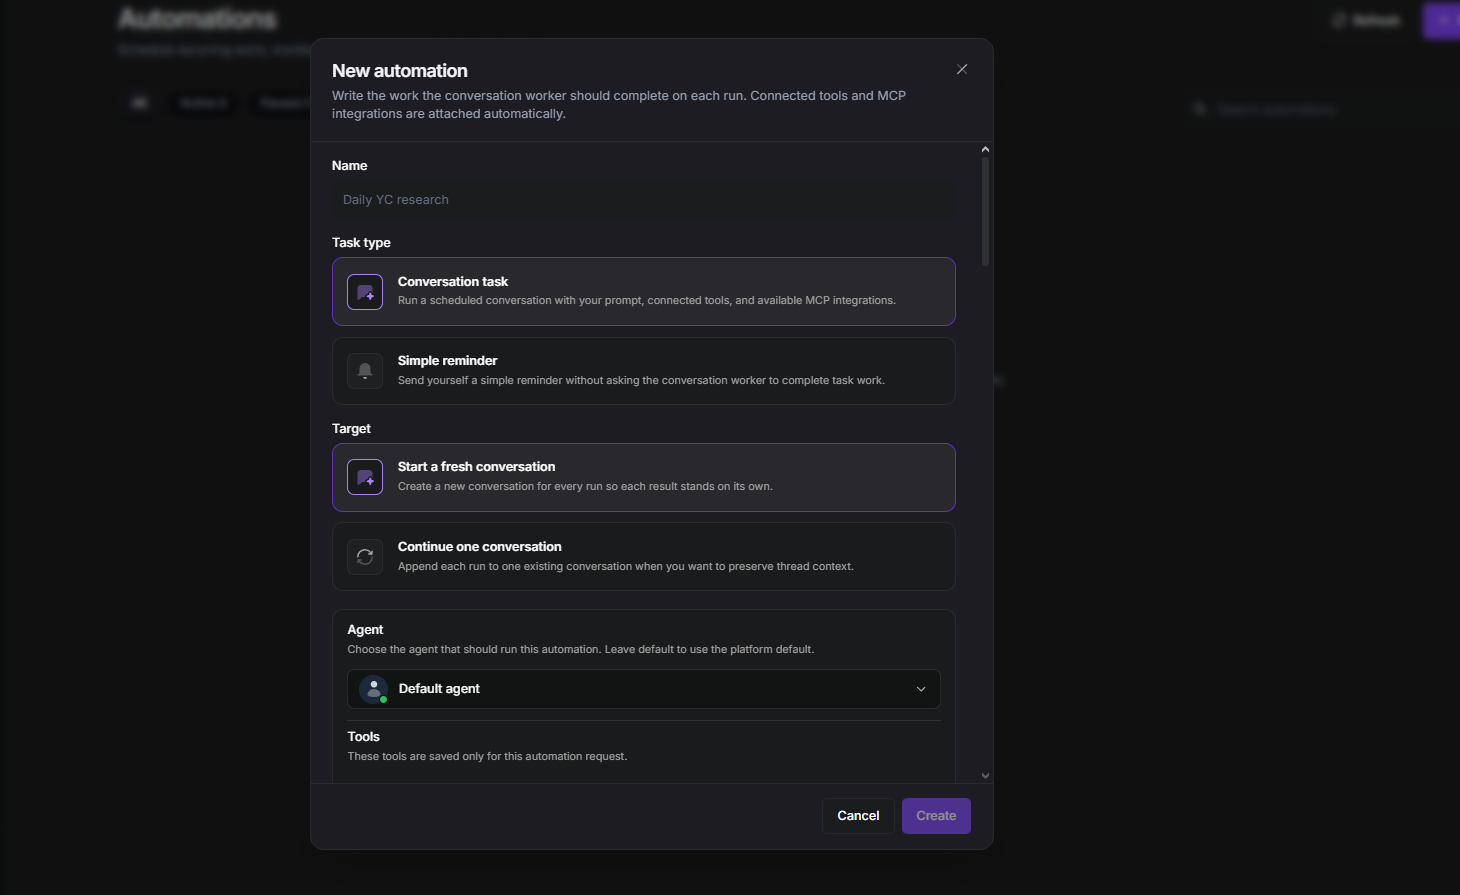
TextCortexはLLMプロバイダーであるだけでなく、EUでホストされGDPRに準拠した企業向けAIプラットフォームもユーザーに提供しています。TextCortexを使えば、幅広いLLMを活用して、複雑で反復的なワークフローを自動化したり、ナレッジマネジメントを強化したりできます。TextCortexのAIエージェントフレームワークを使えば、特定のタスク向けの自動化エージェントを構築できます。さらに、ナレッジベースを使って社内データベースをTextCortexと連携させれば、必要な情報に対話形式でアクセスしたり、生データを役立つアウトプットに変換したりできます。
よくある質問
AIにおけるEUデータレジデンシーとは何ですか?
AIスタック全体で、AI関連のデータがどこで処理・保存・インデックス化・記録されるかを指します。
EUでのホスティングはAI主権と同じですか?
いいえ。EUでのホスティングは場所に関するものです。主権には、管轄、ガバナンス、管理、運用上の独立性も含まれます。
企業は推論の場所以外に何を確認すべきですか?
検索、コンテキスト、ログについても確認する必要があります。
米国のモデルプロバイダーを利用するAIツールでもGDPRに準拠できますか?
アーキテクチャ、契約、保護措置、データフロー、ガバナンス管理によって異なります。購入担当者は、処理チェーン全体を確認する必要があります。