Residência de dados na UE refere-se à localização física ou geográfica onde os dados digitais de uma organização são armazenados e processados, especificamente dentro das fronteiras da União Europeia (UE) ou do Espaço Econômico Europeu (EEE). A residência de dados na UE é importante para empresas e organizações em termos de conformidade regulatória, soberania de dados e confiança dos usuários. Se você quer entender o que a residência de dados na UE significa para a stack de IA de uma empresa e conhecer os pontos que precisa verificar antes de escolher uma plataforma de IA, este guia é para você!
Neste artigo, vamos explicar o que é residência de dados na UE e o que ela realmente significa para as stacks de IA corporativas.
TL;DR
Residência de dados na UE significa armazenar e processar todos os dados de IA de uma empresa dentro das fronteiras da UE ou do EEE, o que abrange não apenas onde o modelo é executado, mas também onde ficam os prompts, o conteúdo recuperado, o contexto e os logs. O conceito se diferencia de outros relacionados: residência diz respeito à localização, soberania à jurisdição legal e conformidade ao cumprimento dos requisitos de governança. Para avaliar corretamente o que uma plataforma de IA afirma sobre residência, verifique quatro superfícies: inferência (onde os prompts são processados e as respostas geradas), índices de recuperação (onde o conhecimento da empresa é indexado e os embeddings armazenados), janela de contexto (como o histórico de conversas, a memória e os arquivos anexados são retidos e gerenciados) e logs de raciocínio (metadados operacionais, rastros de ferramentas e registros de observabilidade). Um fornecedor que afirma ser "hospedado na Europa" sem deixar claras as quatro camadas deixa lacunas de conformidade. A TextCortex cobre as quatro superfícies e oferece mais de 24 LLMs hospedados na UE e em conformidade com o RGPD (incluindo GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro e alternativas econômicas como Kimi K2.6, GLM 5.2 e DeepSeek V4 Pro) por meio de uma única API, com monitoramento, registro e auditoria integrados, agentes de IA e bases de conhecimento corporativas.
O que a residência de dados na UE significa para a IA
A residência de dados de IA na UE é o caminho mais rápido para que organizações e empresas usem IA generativa, agentes de IA e modelos de IA sem comprometer a proteção de dados. A residência de dados na UE para IA não se limita a armazenar os dados do modelo em servidores hospedados na UE; ela também exige que todos os dados de entrada e saída do modelo sejam processados dentro das fronteiras da UE ou do EEE.
Por que a residência de dados na UE é importante?
O ponto central da residência de dados na UE é garantir que o fluxo de dados de empresas e organizações permaneça dentro das fronteiras da UE em cada etapa do fluxo de trabalho, evitando vazamentos de dados. A residência de dados na UE protege informações sensíveis da organização ou do negócio, incluindo prompts, conteúdo recuperado, logs, respostas e outros dados usados ou gerados pela IA. Assim, como usuário, você consegue rastrear e mapear com clareza onde os dados da sua organização são processados, armazenados e registrados.
A diferença entre residência de dados, soberania e conformidade
À primeira vista, residência de dados, soberania e conformidade podem parecer a mesma coisa, mas são aspectos diferentes de questões semelhantes. Podemos resumir brevemente a diferença entre esses três conceitos assim:
- Residência de dados: onde os dados são armazenados ou processados.
- Soberania de dados: qual jurisdição legal pode afetar esses dados.
- Conformidade: se a configuração como um todo atende aos requisitos legais e de governança.
Embora a hospedagem na UE seja importante para plataformas de IA, ela é apenas uma parte do quadro geral.
As 4 superfícies da residência de dados de IA na UE
A residência de dados de IA não se resume a onde o aplicativo está hospedado. Ela também inclui onde os prompts são processados, onde os dados da empresa são indexados, quanto contexto é retido e o que é gravado nos logs. É por isso que a forma mais sólida de avaliar a residência de uma IA é por meio de 4 superfícies: inferência, recuperação, contexto e logs.
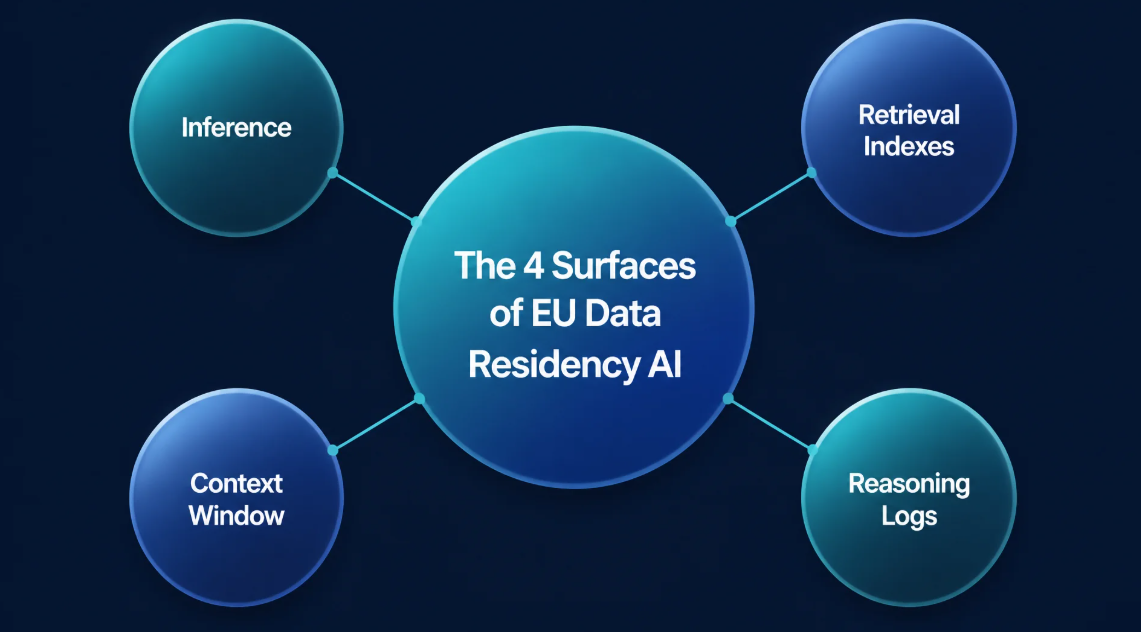
Camada 1: Inferência
É o momento em que um usuário insere um prompt, o modelo o processa e a resposta é gerada. Em outras palavras, a inferência é onde a sua solicitação de fato se torna uma resposta. Se você está avaliando uma plataforma de IA para uso corporativo, esse é um dos primeiros pontos a verificar. A inferência pode envolver documentos internos, dados de clientes, questões jurídicas, notas estratégicas ou detalhes operacionais. Se a camada de inferência não estiver clara, toda a sua implementação de IA fica mais difícil de governar. Por isso, a inferência nunca deve ser reduzida a uma frase de marketing como "hospedado na Europa". Você precisa de uma resposta clara sobre onde as solicitações são processadas, como os dados fluem durante a geração e se os dados dos prompts são retidos depois que a resposta é produzida.
Camada 2: Índices de recuperação
A segunda superfície são os índices de recuperação. Se a IA pode acessar o seu conhecimento, você precisa saber onde esse conhecimento é indexado. Muitas ferramentas de IA corporativas fazem mais do que gerar respostas a partir de um prompt. Elas também se conectam a dados da empresa, como documentos internos, wikis, artigos de suporte, PDFs, anotações de reuniões ou drives na nuvem. Para tornar essas informações pesquisáveis, a plataforma costuma criar índices. É aqui que muitos compradores perdem de vista o quadro geral. Um fornecedor pode dizer que seu chat é hospedado na UE, mas, se a camada de recuperação armazena os dados indexados da empresa em outro lugar, a questão da residência não está totalmente respondida. Você precisa saber onde ficam esses índices, onde os embeddings são armazenados, onde o conteúdo sincronizado é processado e se as fontes conectadas permanecem dentro da região pretendida.
Por que isso é importante?
Porque os índices de recuperação costumam conter a estrutura do conhecimento da sua empresa. Eles podem não se parecer com o documento original, mas ainda representam dados corporativos. Se o seu assistente de IA pode pesquisar políticas de RH, conteúdo de atendimento ao cliente, modelos jurídicos ou documentação de produtos, a camada de recuperação se torna uma parte importante da sua análise de conformidade e governança.
Camada 3: Janela de contexto
A terceira superfície é a janela de contexto. É a camada que dá continuidade aos sistemas de IA. Ela inclui as informações levadas para uma sessão para que o modelo possa gerar uma resposta mais relevante. Dependendo da plataforma, isso pode incluir o histórico recente de conversas, instruções do espaço de trabalho, memória, configurações de agentes, arquivos anexados e contexto específico do usuário.
Por que isso é importante?
Porque é o contexto que torna a IA corporativa realmente útil. Ele ajuda o sistema a entender o que a sua equipe está perguntando, em quais dados deve se basear e como deve responder. Mas, ao mesmo tempo, o contexto também pode incluir material sensível que precisa ser gerenciado com cuidado. Por isso, você precisa saber por quanto tempo os históricos de conversa são armazenados, se os administradores podem controlar a retenção e se a memória é limitada por espaço de trabalho, usuário ou projeto.
Camada 4: Logs de raciocínio
A última, mas não menos importante, superfície são os logs de raciocínio. Logs de raciocínio são os registros criados sobre como uma solicitação de IA foi tratada. Dependendo da plataforma, podem incluir metadados de uso, rastros de ferramentas, registros de depuração, etapas do fluxo de trabalho, carimbos de data e hora, logs de erros, eventos de monitoramento e outros dados de observabilidade. Essa superfície é fácil de ignorar, mas é uma das mais importantes.
Por que isso é importante?
Porque, mesmo quando um fornecedor limita a retenção de prompts, os logs operacionais ainda podem capturar informações relevantes sobre como o sistema foi usado. Para compradores corporativos, isso afeta a auditabilidade, a resposta a incidentes, as revisões de segurança e a governança interna. Uma plataforma pode parecer sólida no nível da interface, mas, se seus logs de raciocínio forem vagos, irrestritos ou mal documentados, as equipes de segurança vão perceber. É por isso que fornecedores maduros de IA corporativa precisam deixar claro não apenas onde as respostas são geradas, mas também como todo o ciclo de vida de uma solicitação é monitorado e registrado.
TextCortex AI: fornecedora europeia de modelos de ponta e solução de IA corporativa
Se você procura um fornecedor europeu de IA e uma plataforma de ferramentas de IA corporativa que ofereça todos os níveis de residência de dados na UE, a TextCortex é a solução ideal. A TextCortex é uma plataforma que busca atender às necessidades de IA das empresas oferecendo aos seus usuários modelos de IA de ponta hospedados na UE e em conformidade com o RGPD. Com a TextCortex, você pode usar mais de 24 grandes modelos de linguagem por meio de uma única API, em conformidade com a residência de dados na UE. Além disso, a TextCortex oferece monitoramento, registro e auditoria aos seus usuários, para que você sempre acompanhe seus modelos de IA. Vamos conhecer mais de perto os recursos da TextCortex.
Acesso a LLMs hospedados na UE
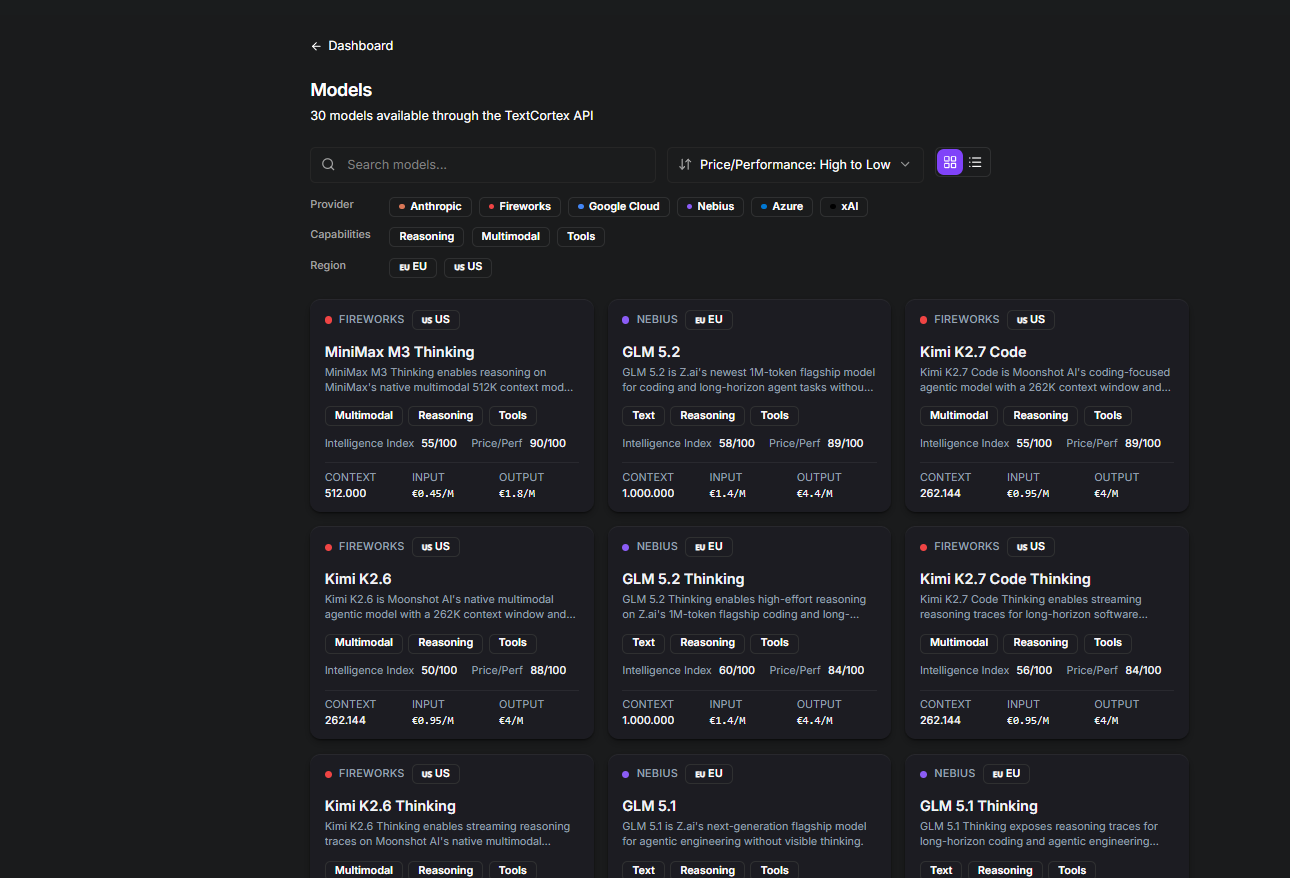
A TextCortex permite que os usuários utilizem 30 modelos diferentes por meio de uma única API, todos hospedados na UE e em conformidade com o RGPD. Entre eles estão modelos de IA de ponta como GPT-5.5, Claude Opus 4.7 e Gemini 3.1 Pro, além de opções alternativas e econômicas como KimiK2.6, GLM 5.2 e DeepSeek V4 Pro.
Experiência de IA corporativa hospedada na UE
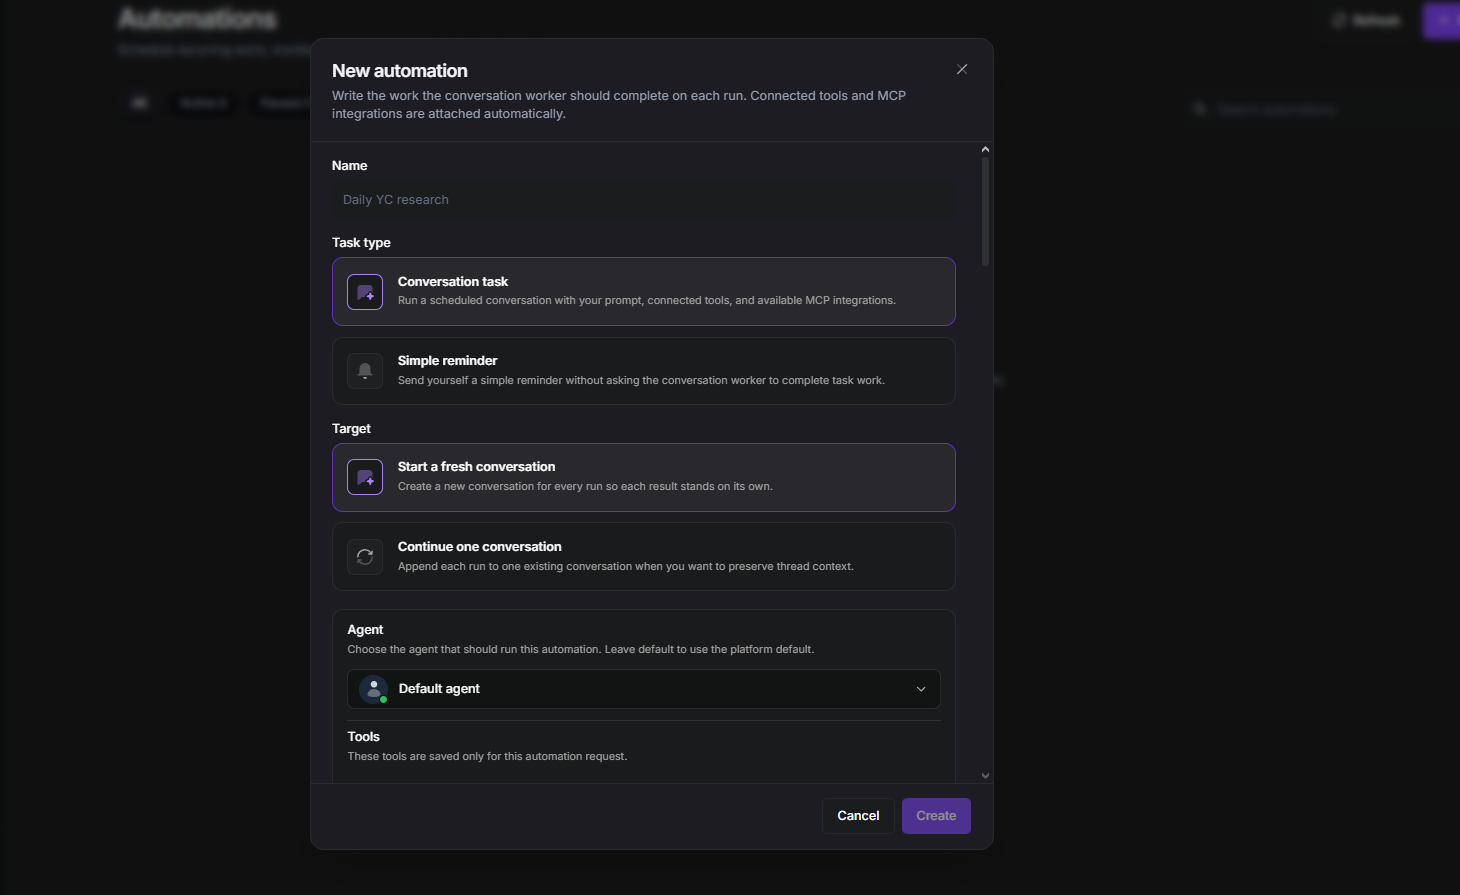
Além de ser fornecedora de LLMs, a TextCortex também oferece aos seus usuários uma plataforma de IA corporativa hospedada na UE e em conformidade com o RGPD. Com a TextCortex, você pode automatizar fluxos de trabalho complexos e repetitivos ou aprimorar sua gestão do conhecimento usando uma ampla variedade de LLMs. Você pode criar agentes de automação para tarefas específicas com o framework de agentes de IA da TextCortex. Além disso, com nossas bases de conhecimento, você pode integrar seus bancos de dados internos à TextCortex para acessar as informações de que precisa em formato de conversa ou transformar seus dados brutos em resultados úteis.
Perguntas frequentes
O que é residência de dados na UE para IA?
Refere-se a onde os dados relacionados à IA são processados, armazenados, indexados ou registrados em toda a stack de IA.
Hospedagem na UE é o mesmo que soberania de IA?
Não. A hospedagem na UE diz respeito à localização. A soberania também inclui jurisdição, governança, controle e independência operacional.
O que as empresas devem verificar além do local da inferência?
Elas também devem verificar a recuperação, o contexto e os logs.
Uma ferramenta de IA pode estar em conformidade com o RGPD se usar fornecedores de modelos dos EUA?
Isso depende da arquitetura, dos contratos, das salvaguardas, dos fluxos de dados e dos controles de governança. Os compradores devem verificar toda a cadeia de processamento.