La residencia de datos en la UE se refiere a la ubicación física o geográfica en la que se almacenan y procesan los datos digitales de una organización, concretamente dentro de las fronteras de la Unión Europea (UE) o del Espacio Económico Europeo (EEE). Para empresas y organizaciones, la residencia de datos en la UE es importante por el cumplimiento normativo, la soberanía de los datos y la confianza de los usuarios. Si te preguntas qué implica la residencia de datos en la UE para el stack de IA de una empresa y quieres conocer los puntos que debes verificar antes de elegir una plataforma de IA, ¡aquí te lo contamos!
En este artículo, explicaremos qué es la residencia de datos en la UE y qué significa realmente para los stacks de IA empresariales.
TL;DR
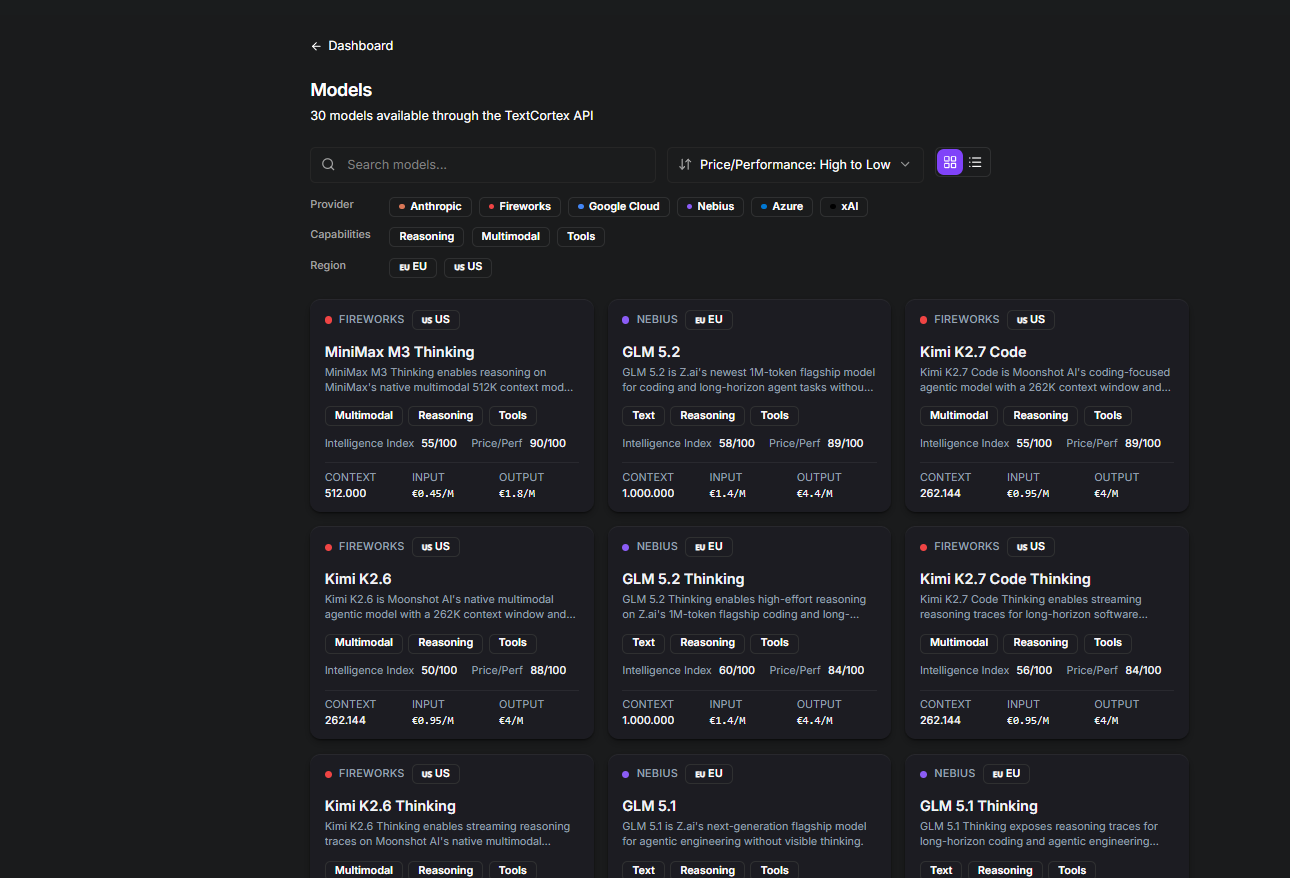
La residencia de datos en la UE significa almacenar y procesar todos los datos de IA de una empresa dentro de las fronteras de la UE o del EEE, lo que abarca no solo dónde se ejecuta el modelo, sino también dónde residen los prompts, el contenido recuperado, el contexto y los registros. Se diferencia de otros conceptos relacionados: la residencia tiene que ver con la ubicación, la soberanía con la jurisdicción legal y el cumplimiento con satisfacer los requisitos de gobernanza. Para evaluar correctamente lo que una plataforma de IA afirma sobre la residencia, revisa cuatro superficies: inferencia (dónde se procesan los prompts y se generan las respuestas), índices de recuperación (dónde se indexa el conocimiento de la empresa y se almacenan los embeddings), ventana de contexto (cómo se conservan y gestionan el historial de conversaciones, la memoria y los archivos adjuntos) y registros de razonamiento (metadatos operativos, trazas de herramientas y registros de observabilidad). Un proveedor que asegura estar «alojado en Europa» sin aclarar las cuatro capas deja lagunas de cumplimiento. TextCortex cubre las cuatro superficies y ofrece más de 24 LLM alojados en la UE y conformes con el RGPD (entre ellos GPT-5.5, Claude Opus 4.7, Gemini 3.1 Pro y alternativas económicas como Kimi K2.6, GLM 5.2 y DeepSeek V4 Pro) a través de una única API, con monitorización, registro y auditoría integrados, agentes de IA y bases de conocimiento empresariales.
Qué significa la residencia de datos en la UE para la IA
La residencia de datos de IA en la UE es la forma más rápida para que organizaciones y empresas usen IA generativa, agentes de IA y modelos de IA sin comprometer la protección de datos. La residencia de datos en la UE para la IA no se limita a almacenar los datos del modelo en servidores alojados en la UE; también exige que todos los datos de entrada y salida del modelo se procesen dentro de las fronteras de la UE o del EEE.
¿Por qué es importante la residencia de datos en la UE?
La clave de la residencia de datos en la UE es garantizar que el flujo de datos de empresas y organizaciones permanezca dentro de las fronteras de la UE en cada paso del flujo de trabajo, evitando fugas de datos. La residencia de datos en la UE protege la información sensible de la organización o del negocio, incluidos los prompts, el contenido recuperado, los registros, las respuestas y otros datos que la IA utiliza o genera. Así, como usuario, puedes rastrear y mapear con claridad dónde se procesan, almacenan y registran los datos de tu organización.
Diferencias entre residencia de datos, soberanía y cumplimiento
A primera vista, la residencia de datos, la soberanía y el cumplimiento pueden parecer lo mismo, pero son aspectos distintos de cuestiones similares. Podemos resumir brevemente la diferencia entre estos tres conceptos así:
- Residencia de datos: dónde se almacenan o procesan los datos.
- Soberanía de datos: qué jurisdicción legal puede afectar a esos datos.
- Cumplimiento: si la configuración en su conjunto cumple los requisitos legales y de gobernanza.
Aunque el alojamiento en la UE es importante para las plataformas de IA, es solo una parte del panorama general.
Las 4 superficies de la residencia de datos de IA en la UE
La residencia de datos de IA no se limita a dónde está alojada la aplicación. También incluye dónde se procesan los prompts, dónde se indexan los datos de la empresa, cuánto contexto se conserva y qué se escribe en los registros. Por eso, la forma más sólida de evaluar la residencia de la IA es a través de 4 superficies: inferencia, recuperación, contexto y registros.
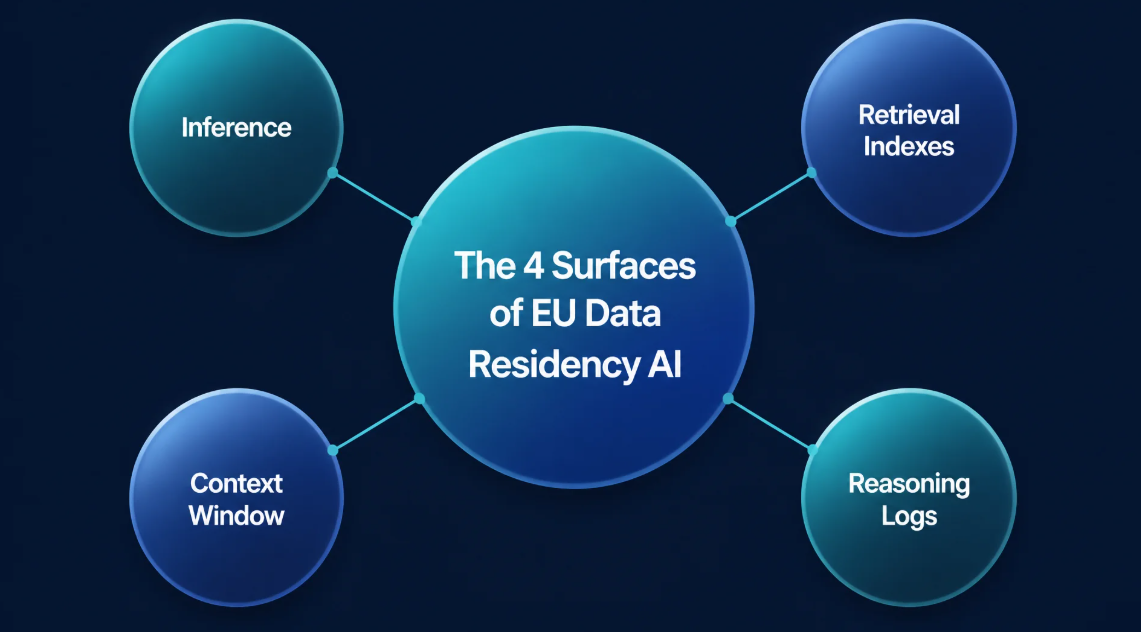
Capa 1: Inferencia
Es el momento en que un usuario introduce un prompt, el modelo lo procesa y se genera la respuesta. En otras palabras, la inferencia es donde tu solicitud se convierte realmente en una respuesta. Si estás evaluando una plataforma de IA para uso empresarial, esto es una de las primeras cosas que debes comprobar. La inferencia puede incluir documentos internos, datos de clientes, consultas legales, notas estratégicas o detalles operativos. Si la capa de inferencia no está clara, todo tu despliegue de IA se vuelve más difícil de gobernar. Por eso, la inferencia nunca debería reducirse a una frase de marketing como «alojado en Europa». Necesitas una respuesta clara sobre dónde se procesan las solicitudes, cómo fluyen los datos durante la generación y si los datos de los prompts se conservan una vez generada la respuesta.
Capa 2: Índices de recuperación
La segunda superficie son los índices de recuperación. Si la IA puede acceder a tu conocimiento, necesitas saber dónde se indexa ese conocimiento. Muchas herramientas de IA empresariales hacen algo más que generar respuestas a partir de un prompt. También se conectan a datos de la empresa, como documentos internos, wikis, artículos de soporte, PDF, notas de reuniones o unidades en la nube. Para que esa información se pueda buscar, la plataforma suele crear índices. Aquí es donde muchos compradores pierden de vista el panorama general. Un proveedor puede decir que su chat está alojado en la UE, pero si la capa de recuperación almacena los datos indexados de la empresa en otro lugar, la cuestión de la residencia no queda del todo resuelta. Necesitas saber dónde residen esos índices, dónde se almacenan los embeddings, dónde se procesa el contenido sincronizado y si las fuentes conectadas permanecen dentro de la región prevista.
¿Por qué es importante?
Porque los índices de recuperación suelen contener la estructura del conocimiento de tu empresa. Puede que no se parezcan al documento original, pero siguen representando datos empresariales. Si tu asistente de IA puede buscar en políticas de RR. HH., contenido de atención al cliente, plantillas legales o documentación de producto, la capa de recuperación se convierte en una parte fundamental de tu revisión de cumplimiento y gobernanza.
Capa 3: Ventana de contexto
La tercera superficie es la ventana de contexto. Es la capa que da continuidad a los sistemas de IA. Incluye la información que se traslada a una sesión para que el modelo pueda generar una respuesta más relevante. Según la plataforma, puede abarcar el historial reciente de conversaciones, las instrucciones del espacio de trabajo, la memoria, la configuración de los agentes, los archivos adjuntos y el contexto específico de cada usuario.
¿Por qué es importante?
Porque el contexto es lo que hace que la IA empresarial sea realmente útil. Ayuda al sistema a entender qué pregunta tu equipo, en qué datos debe basarse y cómo debe responder. Pero, al mismo tiempo, el contexto también puede incluir material sensible que debe gestionarse con cuidado. Por eso, necesitas saber durante cuánto tiempo se almacenan los historiales de conversación, si los administradores pueden controlar la retención y si la memoria está limitada por espacio de trabajo, usuario o proyecto.
Capa 4: Registros de razonamiento
La última superficie, pero no por ello menos importante, son los registros de razonamiento. Se trata de los registros que se generan sobre cómo se gestionó una solicitud de IA. Según la plataforma, pueden incluir metadatos de uso, trazas de herramientas, registros de depuración, pasos del flujo de trabajo, marcas de tiempo, registros de errores, eventos de monitorización y otros datos de observabilidad. Esta superficie es fácil de pasar por alto, pero es una de las más importantes.
¿Por qué es importante?
Porque, incluso cuando un proveedor limita la retención de prompts, los registros operativos pueden seguir capturando información relevante sobre cómo se utilizó el sistema. Para los compradores empresariales, esto afecta a la auditabilidad, la respuesta ante incidentes, la revisión de seguridad y la gobernanza interna. Una plataforma puede parecer sólida a nivel de interfaz, pero si sus registros de razonamiento son vagos, no tienen restricciones o están mal documentados, los equipos de seguridad lo notarán. Por eso, los proveedores maduros de IA empresarial deben ser claros no solo sobre dónde se generan las respuestas, sino también sobre cómo se supervisa y registra todo el ciclo de vida de una solicitud.
TextCortex AI: proveedor europeo de modelos de vanguardia y solución de IA empresarial
Si buscas un proveedor europeo de IA y una plataforma de herramientas de IA empresarial que cubra todos los niveles de residencia de datos en la UE, TextCortex es la solución para ti. TextCortex es una plataforma que busca satisfacer las necesidades de IA de las empresas ofreciendo a sus usuarios modelos de IA de vanguardia alojados en la UE y conformes con el RGPD. Con TextCortex, puedes usar más de 24 grandes modelos de lenguaje a través de una única API, en cumplimiento de la residencia de datos en la UE. Además, TextCortex ofrece a sus usuarios monitorización, registro y auditoría, para que siempre tengas el control de tus modelos de IA. Veamos más de cerca las funciones de TextCortex.
Acceso a LLM alojados en la UE
TextCortex permite a los usuarios utilizar 30 modelos diferentes a través de una única API, todos alojados en la UE y conformes con el RGPD. Entre ellos se encuentran modelos de IA de vanguardia como GPT-5.5, Claude Opus 4.7 y Gemini 3.1 Pro, así como opciones alternativas y económicas como KimiK2.6, GLM 5.2 y DeepSeek V4 Pro.
Experiencia de IA empresarial alojada en la UE
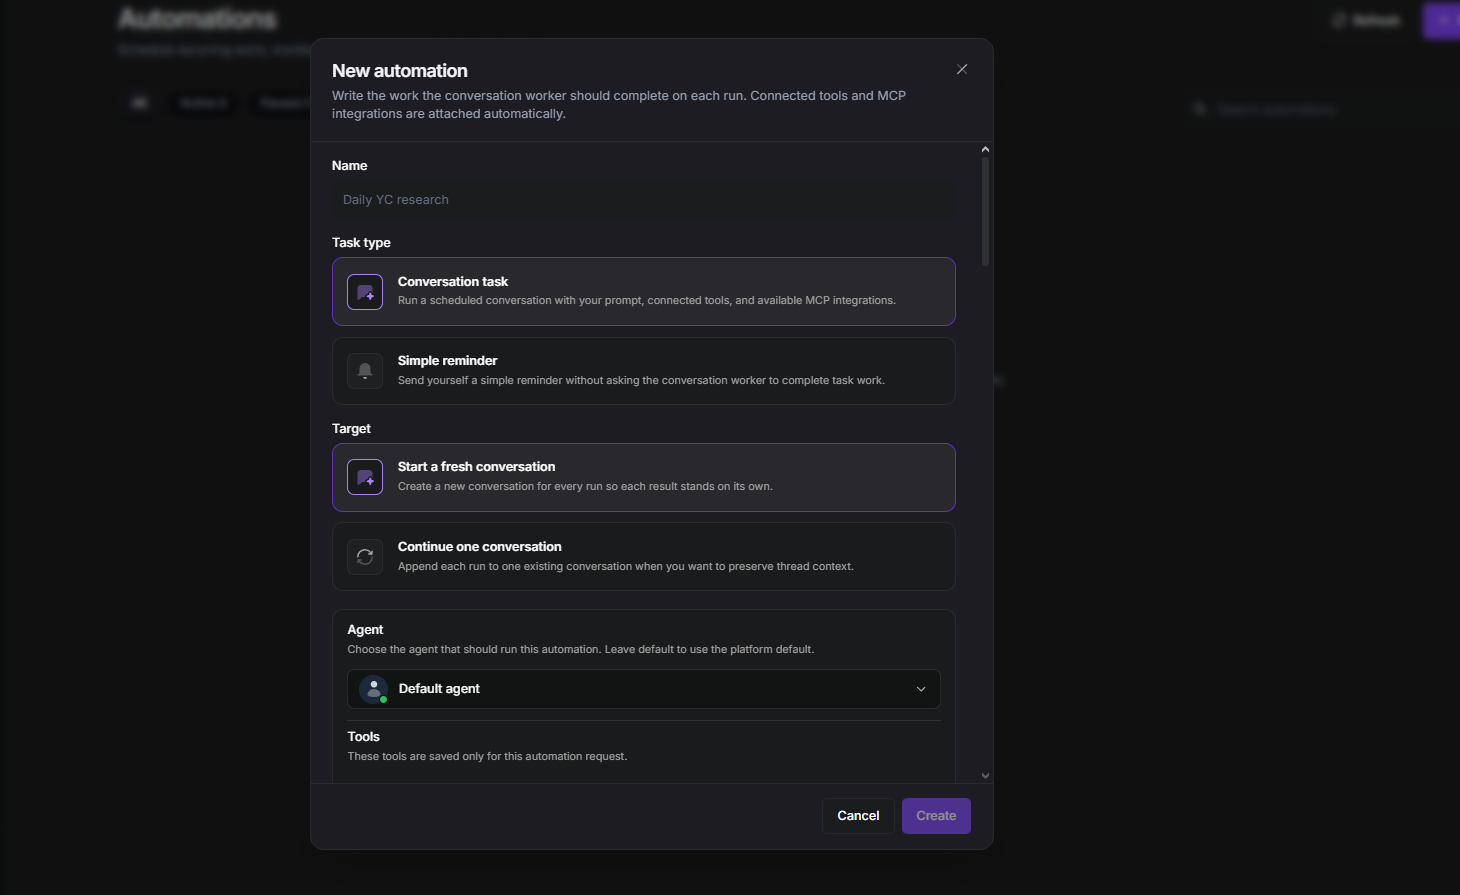
Además de ser proveedor de LLM, TextCortex ofrece a sus usuarios una plataforma de IA empresarial alojada en la UE y conforme con el RGPD. Con TextCortex, puedes automatizar flujos de trabajo complejos y repetitivos o mejorar tu gestión del conocimiento con una amplia variedad de LLM. Puedes crear agentes de automatización para tareas específicas con el framework de agentes de IA de TextCortex. Además, con nuestras bases de conocimiento, puedes integrar tus bases de datos internas con TextCortex para acceder a la información que necesitas en formato conversacional o transformar tus datos en bruto en resultados útiles.
Preguntas frecuentes
¿Qué es la residencia de datos en la UE para la IA?
Se refiere a dónde se procesan, almacenan, indexan o registran los datos relacionados con la IA en todo el stack de IA.
¿El alojamiento en la UE es lo mismo que la soberanía de la IA?
No. El alojamiento en la UE tiene que ver con la ubicación. La soberanía incluye además la jurisdicción, la gobernanza, el control y la independencia operativa.
¿Qué deben comprobar las empresas además de la ubicación de la inferencia?
También deben verificar la recuperación, el contexto y los registros.
¿Puede una herramienta de IA cumplir el RGPD si utiliza proveedores de modelos de EE. UU.?
Depende de la arquitectura, los contratos, las salvaguardas, los flujos de datos y los controles de gobernanza. Los compradores deben verificar toda la cadena de procesamiento.